介绍目前常见前端面试题,参考链接 https://interview2.poetries.top/
JavaScript
❤ this指向
1. this 指向有哪几种
- 默认绑定:全局环境中,
this默认绑定到window - 隐式绑定:一般地,被直接对象所包含的函数调用时,也称为方法调用,
this隐式绑定到该直接对象 - 隐式丢失:隐式丢失是指被隐式绑定的函数丢失绑定对象,从而默认绑定到
window。显式绑定:通过call()、apply()、bind()方法把对象绑定到this上,叫做显式绑定 new绑定:如果函数或者方法调用之前带有关键字new,它就构成构造函数调用。对于this绑定来说,称为new绑定- 构造函数通常不使用
return关键字,它们通常初始化新对象,当构造函数的函数体执行完毕时,它会显式返回。在这种情况下,构造函数调用表达式的计算结果就是这个新对象的值 - 如果构造函数使用
return语句但没有指定返回值,或者返回一个原始值,那么这时将忽略返回值,同时使用这个新对象作为调用结果 - 如果构造函数显式地使用
return语句返回一个对象,那么调用表达式的值就是这个对象
- 构造函数通常不使用
2. 改变函数内部 this 指针的指向函数(bind,apply,call的区别)
apply:调用一个对象的一个方法,用另一个对象替换当前对象。例如:B.apply(A, arguments);即A对象应用B对象的方法call:调用一个对象的一个方法,用另一个对象替换当前对象。例如:B.call(A, args1,args2);即A对象调用B对象的方法bind除了返回是函数以外,它的参数和call一样
3. 箭头函数
- 箭头函数没有
this,所以需要通过查找作用域链来确定this的值,这就意味着如果箭头函数被非箭头函数包含,this绑定的就是最近一层非箭头函数的this, - 箭头函数没有自己的
arguments对象,但是可以访问外围函数的arguments对象 - 不能通过
new关键字调用,同样也没有new.target值和原型
牛客网解释:
- 得分点 全局执行上下文、函数执行上下文、this严格模式下undefined、非严格模式window、构造函数新对象本身、普通函数不继承this、箭头函数无this,可继承
- 标准回答
- this关键字由来:在对象内部的方法中使用对象内部的属性是一个非常普遍的需求。但是 JavaScript 的作用域机制并不支持这一点,基于这个需求,JavaScript 又搞出来另外一套 this 机制。
- this存在的场景有三种 全局执行上下文 和 函数执行上下文 和 eval执行上下文,eval这种不讨论。
- 在全局执行环境中无论是否在严格模式下,(在任何函数体外部)
this都指向全局对象。 - 在函数执行上下文中访问this,函数的调用方式决定了
this的值。在全局环境中调用一个函数,函数内部的 this 指向的是全局变量 window,通过一个对象来调用其内部的一个方法,该方法的执行上下文中的 this 指向对象本身。 - 普通函数this指向:当函数被正常调用时,在严格模式下,this 值是 undefined,非严格模式下 this 指向的是全局对象 window;通过一个对象来调用其内部的一个方法,该方法的执行上下文中的 this 指向对象本身。
- new 关键字构建好了一个新对象,并且构造函数中的 this 其实就是新对象本身。嵌套函数中的 this 不会继承外层函数的 this 值。
- 箭头函数this指向:箭头函数并不会创建其自身的执行上下文,所以箭头函数中的 this 取决于它的外部函数。
- 在全局执行环境中无论是否在严格模式下,(在任何函数体外部)
- 加分回答
- 箭头函数因为没有this,所以也不能作为构造函数,但是需要继承函数外部this的时候,使用箭头函数比较方便
1 | var myObj = { |
❤ This
new 的方式优先级最高,接下来是 bind 这些函数,然后是 obj.foo() 这种调用方式,最后是 foo 这种调用方式,同时,箭头函数的 this 一旦被绑定,就不会再被任何方式所改变。
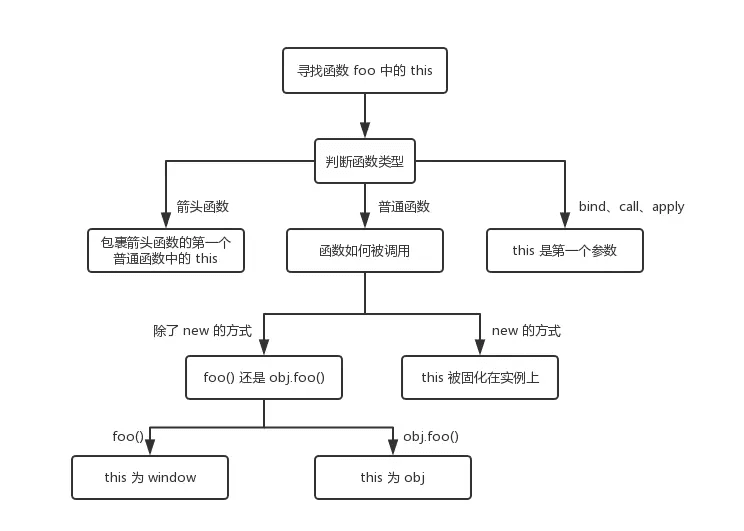
由于 JS 的设计原理: 在函数中,可以引用运行环境中的变量。因此就需要一个机制来让我们可以在函数体内部获取当前的运行环境,这便是this
但这种机制并不完全能满足我们的业务需求,因此提供了三种方式可以手动修改 this 的指向:
call: fn.call(target, 1, 2)apply: fn.apply(target, [1, 2])bind: fn.bind(target)(1,2)
❤ call apply bind的作用和区别
- 得分点 bind改变this指向不直接调用、call和apply改变this指向直接调用、apply接收第二个参数为数组 、call用于对象的继承 、伪数组转换成真数组、apply用于找出数组中的最大值和最小值以及数组合并、bind用于vue或者react框架中改变函数的this指向
- 标准回答
- call、apply、bind的作用都是改变函数运行时的this指向。
- bind和call、apply在使用上有所不同,bind在改变this指向的时候,返回一个改变执行上下文的函数,不会立即执行函数,而是需要调用该函数的时候再调用即可,但是call和apply在改变this指向的同时执行了该函数。
- bind只接收一个参数,就是this指向的执行上文。
- call、apply接收多个参数,第一个参数都是this指向的执行上文,后面的参数都是作为改变this指向的函数的参数。但是call和apply参数的格式不同,call是一个参数对应一个原函数的参数,但是apply第二个参数是数组,数组中每个元素代表函数接收的参数,数组有几个元素函数就接收几个元素。
- 加分回答
call的应用场景: 对象的继承,在子构造函数这种调用父构造函数,但是改变this指向,就可以继承父的属性
1
2
3
4
5
6
7
8
9var arrayLike = {
0: 'java',
1: 'script',
length: 2
}
Array.prototype.push.call(arrayLike, 'jack', 'lily');
console.log(typeof arrayLike); // 'object'
console.log(arrayLike);
// {0: "java", 1: "script", 2: "jack", 3: "lily", length: 4}apply的应用场景:
1 | // 获取数组中最大、最小的一项 |
- bind的应用场景 在vue或者react框架中,使用bind将定义的方法中的this指向当前类
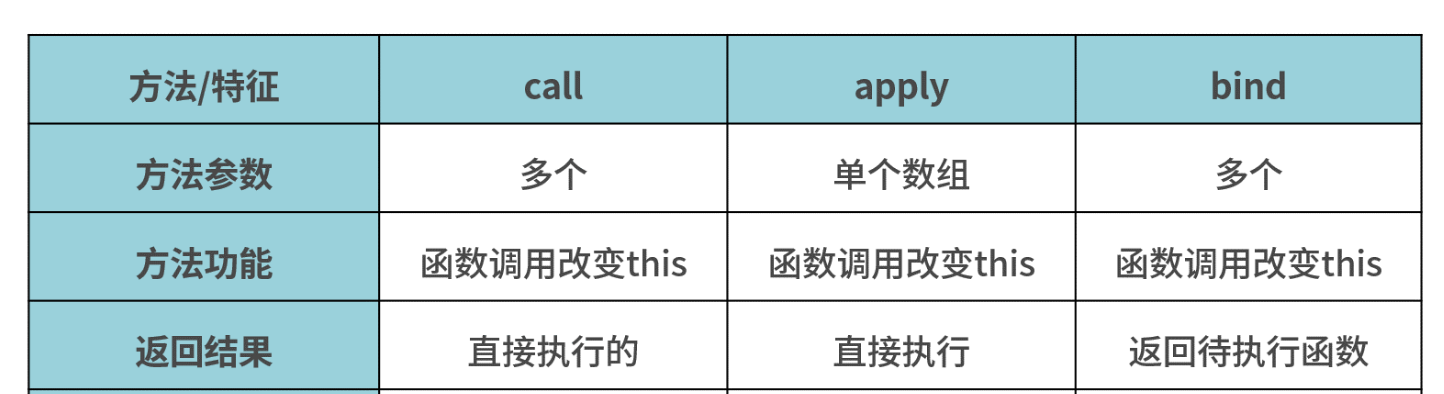
call、apply和bind是挂在Function对象上的三个方法,调用这三个方法的必须是一个函数。
1 | func.call(thisArg, param1, param2, ...) |
- 在浏览器里,在全局范围内this 指向window对象;
- 在函数中,this永远指向最后调用他的那个对象;
- 构造函数中,this指向new出来的那个新的对象;
call、apply、bind中的this被强绑定在指定的那个对象上;- 箭头函数中this比较特殊,箭头函数this为父作用域的this,不是调用时的this.要知道前四种方式,都是调用时确定,也就是动态的,而箭头函数的this指向是静态的,声明的时候就确定了下来;
apply、call、bind都是js给函数内置的一些API,调用他们可以为函数指定this的执行,同时也可以传参。
实现一个 bind 函数
对于实现以下几个函数,可以从几个方面思考
- 不传入第一个参数,那么默认为
window - 改变了
this指向,让新的对象可以执行该函数。那么思路是否可以变成给新的对象添加一个函数,然后在执行完以后删除?
1 | Function.prototype.myBind = function (context) { |
实现一个 call 函数
1 | Function.prototype.myCall = function (context) { |
实现一个 apply 函数
1 | Function.prototype.myApply = function(context = window, ...args) { |
❤ 变量提升
当执行 JS 代码时,会生成执行环境,只要代码不是写在函数中的,就是在全局执行环境中,函数中的代码会产生函数执行环境,只此两种执行环境
1 | b() // call b |
这是因为函数和变量提升的原因。通常提升的解释是说将声明的代码移动到了顶部,这其实没有什么错误,便于大家理解。但是更准确的解释应该是:在生成执行环境时,会有两个阶段。第一个阶段是创建的阶段,JS 解释器会找出需要提升的变量和函数,并且给他们提前在内存中开辟好空间,函数的话会将整个函数存入内存中,变量只声明并且赋值为
undefined,所以在第二个阶段,也就是代码执行阶段,我们可以直接提前使用
- 在提升的过程中,相同的函数会覆盖上一个函数,并且函数优先于变量提升
1 | b() // call b second |
var会产生很多错误,所以在ES6中引入了let。let不能在声明前使用,但是这并不是常说的let不会提升,let提升了,在第一阶段内存也已经为他开辟好了空间,但是因为这个声明的特性导致了并不能在声明前使用
- 得分点 Var声明的变量声明提升、函数声明提升、let和const变量不提升
- 标准回答
- 变量提升是指JS的变量和函数声明会在代码编译期,提升到代码的最前面。
- 变量提升成立的前提是使用Var关键字进行声明的变量,并且变量提升的时候只有声明被提升,赋值并不会被提升,同时函数的声明提升会比变量的提升优先。
- 变量提升的结果,可以在变量初始化之前访问该变量,返回的是undefined。在函数声明前可以调用该函数。
- 加分回答
- 使用let和const声明的变量是创建提升,形成暂时性死区,在初始化之前访问let和const创建的变量会报错。
解释 JS 中的作用域与变量声明提升
JavaScript作用域:- 在
Java、C等语言中,作用域为for语句、if语句或{}内的一块区域,称为作用域; - 而在
JavaScript中,作用域为function(){}内的区域,称为函数作用域。
- 在
JavaScript变量声明提升:- 在
JavaScript中,函数声明与变量声明经常被JavaScript引擎隐式地提升到当前作用域的顶部。 - 声明语句中的赋值部分并不会被提升,只有名称被提升
- 函数声明的优先级高于变量,如果变量名跟函数名相同且未赋值,则函数声明会覆盖变量声明
- 如果函数有多个同名参数,那么最后一个参数(即使没有定义)会覆盖前面的同名参数
- 在
❤ 作用域
- 作用域: 作用域是定义变量的区域,它有一套访问变量的规则,这套规则来管理浏览器引擎如何在当前作用域以及嵌套的作用域中根据变量(标识符)进行变量查找
- 作用域链: 作用域链的作用是保证对执行环境有权访问的所有变量和函数的有序访问,通过作用域链,我们可以访问到外层环境的变量和 函数。
作用域链的本质上是一个指向变量对象的指针列表。变量对象是一个包含了执行环境中所有变量和函数的对象。作用域链的前 端始终都是当前执行上下文的变量对象。全局执行上下文的变量对象(也就是全局对象)始终是作用域链的最后一个对象。
- 当我们查找一个变量时,如果当前执行环境中没有找到,我们可以沿着作用域链向后查找
- 作用域链的创建过程跟执行上下文的建立有关….
作用域可以理解为变量的可访问性,总共分为三种类型,分别为:
- 全局作用域
- 函数作用域
- 块级作用域,ES6 中的
let、const就可以产生该作用域
其实看完前面的闭包、this 这部分内部的话,应该基本能了解作用域的一些应用。
一旦我们将这些作用域嵌套起来,就变成了另外一个重要的知识点「作用域链」,也就是 JS 到底是如何访问需要的变量或者函数的。
- 首先作用域链是在定义时就被确定下来的,和箭头函数里的 this 一样,后续不会改变,JS 会一层层往上寻找需要的内容。
- 其实作用域链这个东西我们在闭包小结中已经看到过它的实体了:
[[Scopes]]
图中的 [[Scopes]] 是个数组,作用域的一层层往上寻找就等同于遍历 [[Scopes]]。
JS 作用链域
- 全局函数无法查看局部函数的内部细节,但局部函数可以查看其上层的函数细节,直至全局细节
- 如果当前作用域没有找到属性或方法,会向上层作用域查找,直至全局函数,这种形式就是作用域链
❤ 闭包
闭包其实就是一个可以访问其他函数内部变量的函数。创建闭包的最常见的方式就是在一个函数内创建另一个函数,创建的函数可以 访问到当前函数的局部变量。
闭包产生的本质就是:当前环境中存在指向父级作用域的引用
闭包有两个常用的用途
- 闭包的第一个用途是使我们在函数外部能够访问到函数内部的变量。通过使用闭包,我们可以通过在外部调用闭包函数,从而在外部访问到函数内部的变量,可以使用这种方法来创建私有变量。
- 函数的另一个用途是使已经运行结束的函数上下文中的变量对象继续留在内存中,因为闭包函数保留了这个变量对象的引用,所以这个变量对象不会被回收。
其实闭包的本质就是作用域链的一个特殊的应用,只要了解了作用域链的创建过程,就能够理解闭包的实现原理。
- 闭包的特性:
- 函数内再嵌套函数
- 内部函数可以引用外层的参数和变量
- 参数和变量不会被垃圾回收机制回收
说说你对闭包的理解
- 使用闭包主要是为了设计私有的方法和变量。
- 闭包的优点是可以避免全局变量的污染,
- 缺点是闭包会常驻内存,会增大内存使用量,使用不当很容易造成内存泄露。在js中,函数即闭包,只有函数才会产生作用域的概念
- 闭包 的最大用处有两个,一个是可以读取函数内部的变量,另一个就是让这些变量始终保持在内存中
- 闭包的另一个用处,是封装对象的私有属性和私有方法
- 好处:能够实现封装和缓存等;
- 坏处:就是消耗内存、不正当使用会造成内存溢出的问题
使用闭包的注意点
- 由于闭包会使得函数中的变量都被保存在内存中,内存消耗很大,所以不能滥用闭包,否则会造成网页的性能问题,在IE中可能导致内存泄露
- 解决方法是,在退出函数之前,将不使用的局部变量全部删除
- 得分点:变量背包、作用域链、局部变量不销毁、函数体外访问函数的内部变量、内存泄漏、内存溢出、形成块级作用域、柯里化、构造函数中定义特权方法、Vue中数据响应式Observer
- 标准回答:闭包 一个函数和词法环境的引用捆绑在一起,这样的组合就是闭包(closure)。
- 一般就是一个函数A,return其内部的函数B,被return出去的B函数能够在外部访问A函数内部的变量,这时候就形成了一个B函数的变量背包,A函数执行结束后这个变量背包也不会被销毁,并且这个变量背包在A函数外部只能通过B函数访问。
- 形成的原理:作用域链,当前作用域可以访问上级作用域中的变量
- 解决的问题:能够让函数作用域中的变量在函数执行结束之后不被销毁,同时也能在函数外部可以访问函数内部的局部变量。
- 带来的问题:由于垃圾回收器不会将闭包中变量销毁,于是就造成了内存泄露,内存泄露积累多了就容易导致内存溢出。
- 加分回答:
- 闭包的应用,能够模仿块级作用域,能够实现柯里化,在构造函数中定义特权方法、Vue中数据响应式Observer中使用闭包等。
❤ New的原理
得分点 创建空对象、为对象添加属性、把新对象当作this的上下文、箭头函数不能作为构造函数
标准回答
new操作符可以帮助我们构建出一个实例,并且绑定上 this,内部执行步骤可大概分为以下几步:- 创建一个新对象
- 对象连接到构造函数原型上,并绑定
this(this 指向新对象) - 执行构造函数代码(为这个新对象添加属性)
- 返回新对象
在第四步返回新对象这边有一个情况会例外:
那么问题来了,如果不用
new这个关键词,结合上面的代码改造一下,去掉new,会发生什么样的变化呢?我们再来看下面这段代码1
2
3
4
5
6
7function Person(){
this.name = 'Jack';
}
var p = Person();
console.log(p) // undefined
console.log(name) // Jack
console.log(p.name) // 'name' of undefined从上面的代码中可以看到,我们没有使用
new这个关键词,返回的结果就是undefined。其中由于JavaScript代码在默认情况下this的指向是window,那么name的输出结果就为Jack,这是一种不存在new关键词的情况。那么当构造函数中有
return一个对象的操作,结果又会是什么样子呢?我们再来看一段在上面的基础上改造过的代码。1
2
3
4
5
6
7
8function Person(){
this.name = 'Jack';
return {age: 18}
}
var p = new Person();
console.log(p) // {age: 18}
console.log(p.name) // undefined
console.log(p.age) // 18通过这段代码又可以看出,当构造函数最后
return出来的是一个和this无关的对象时,new 命令会直接返回这个新对象,而不是通过 new 执行步骤生成的 this 对象但是这里要求构造函数必须是返回一个对象,
如果返回的不是对象,那么还是会按照 new 的实现步骤,返回新生成的对象。接下来还是在上面这段代码的基础之上稍微改动一下1
2
3
4
5
6
7function Person(){
this.name = 'Jack';
return 'tom';
}
var p = new Person();
console.log(p) // {name: 'Jack'}
console.log(p.name) // Jack可以看出,当构造函数中
return的不是一个对象时,那么它还是会根据new关键词的执行逻辑,生成一个新的对象(绑定了最新this),最后返回出来因此我们总结一下:
new 关键词执行之后总是会返回一个对象,要么是实例对象,要么是 return 语句指定的对象加分回答
new关键字后面的构造函数不能是箭头函数。
❤ 原型,原型链
__proto__和prototype关系:__proto__和constructor是对象独有的。prototype属性是函数独有的
当我们访问一个对象的属性时,如果这个对象内部不存在这个属性,那么它就会去它的原型对象里找这个属性,这个原型对象又会有自己的原型,于是就这样一直找下去,也就是原型链的概念。原型链的尽头一般来说都是 Object.prototype 所以这就是我们新建的对象为什么能够使用 toString() 等方法的原因。
特点:JavaScript 对象是通过引用来传递的,我们创建的每个新对象实体中并没有一份属于自己的原型副本。当我们修改原型时,与 之相关的对象也会继承这一改变
- 原型(
prototype): 一个简单的对象,用于实现对象的 属性继承。可以简单的理解成对象的爹。在Firefox和Chrome中,每个JavaScript对象中都包含一个__proto__(非标准)的属性指向它爹(该对象的原型),可obj.__proto__进行访问。 - 构造函数: 可以通过
new来 新建一个对象 的函数。 - 实例: 通过构造函数和
new创建出来的对象,便是实例。 实例通过__proto__指向原型,通过constructor指向构造函数。
1 | // 实例 |
这里我们可以来看出三者的关系:
实例.__proto__ === 原型原型.constructor === 构造函数构造函数.prototype === 原型
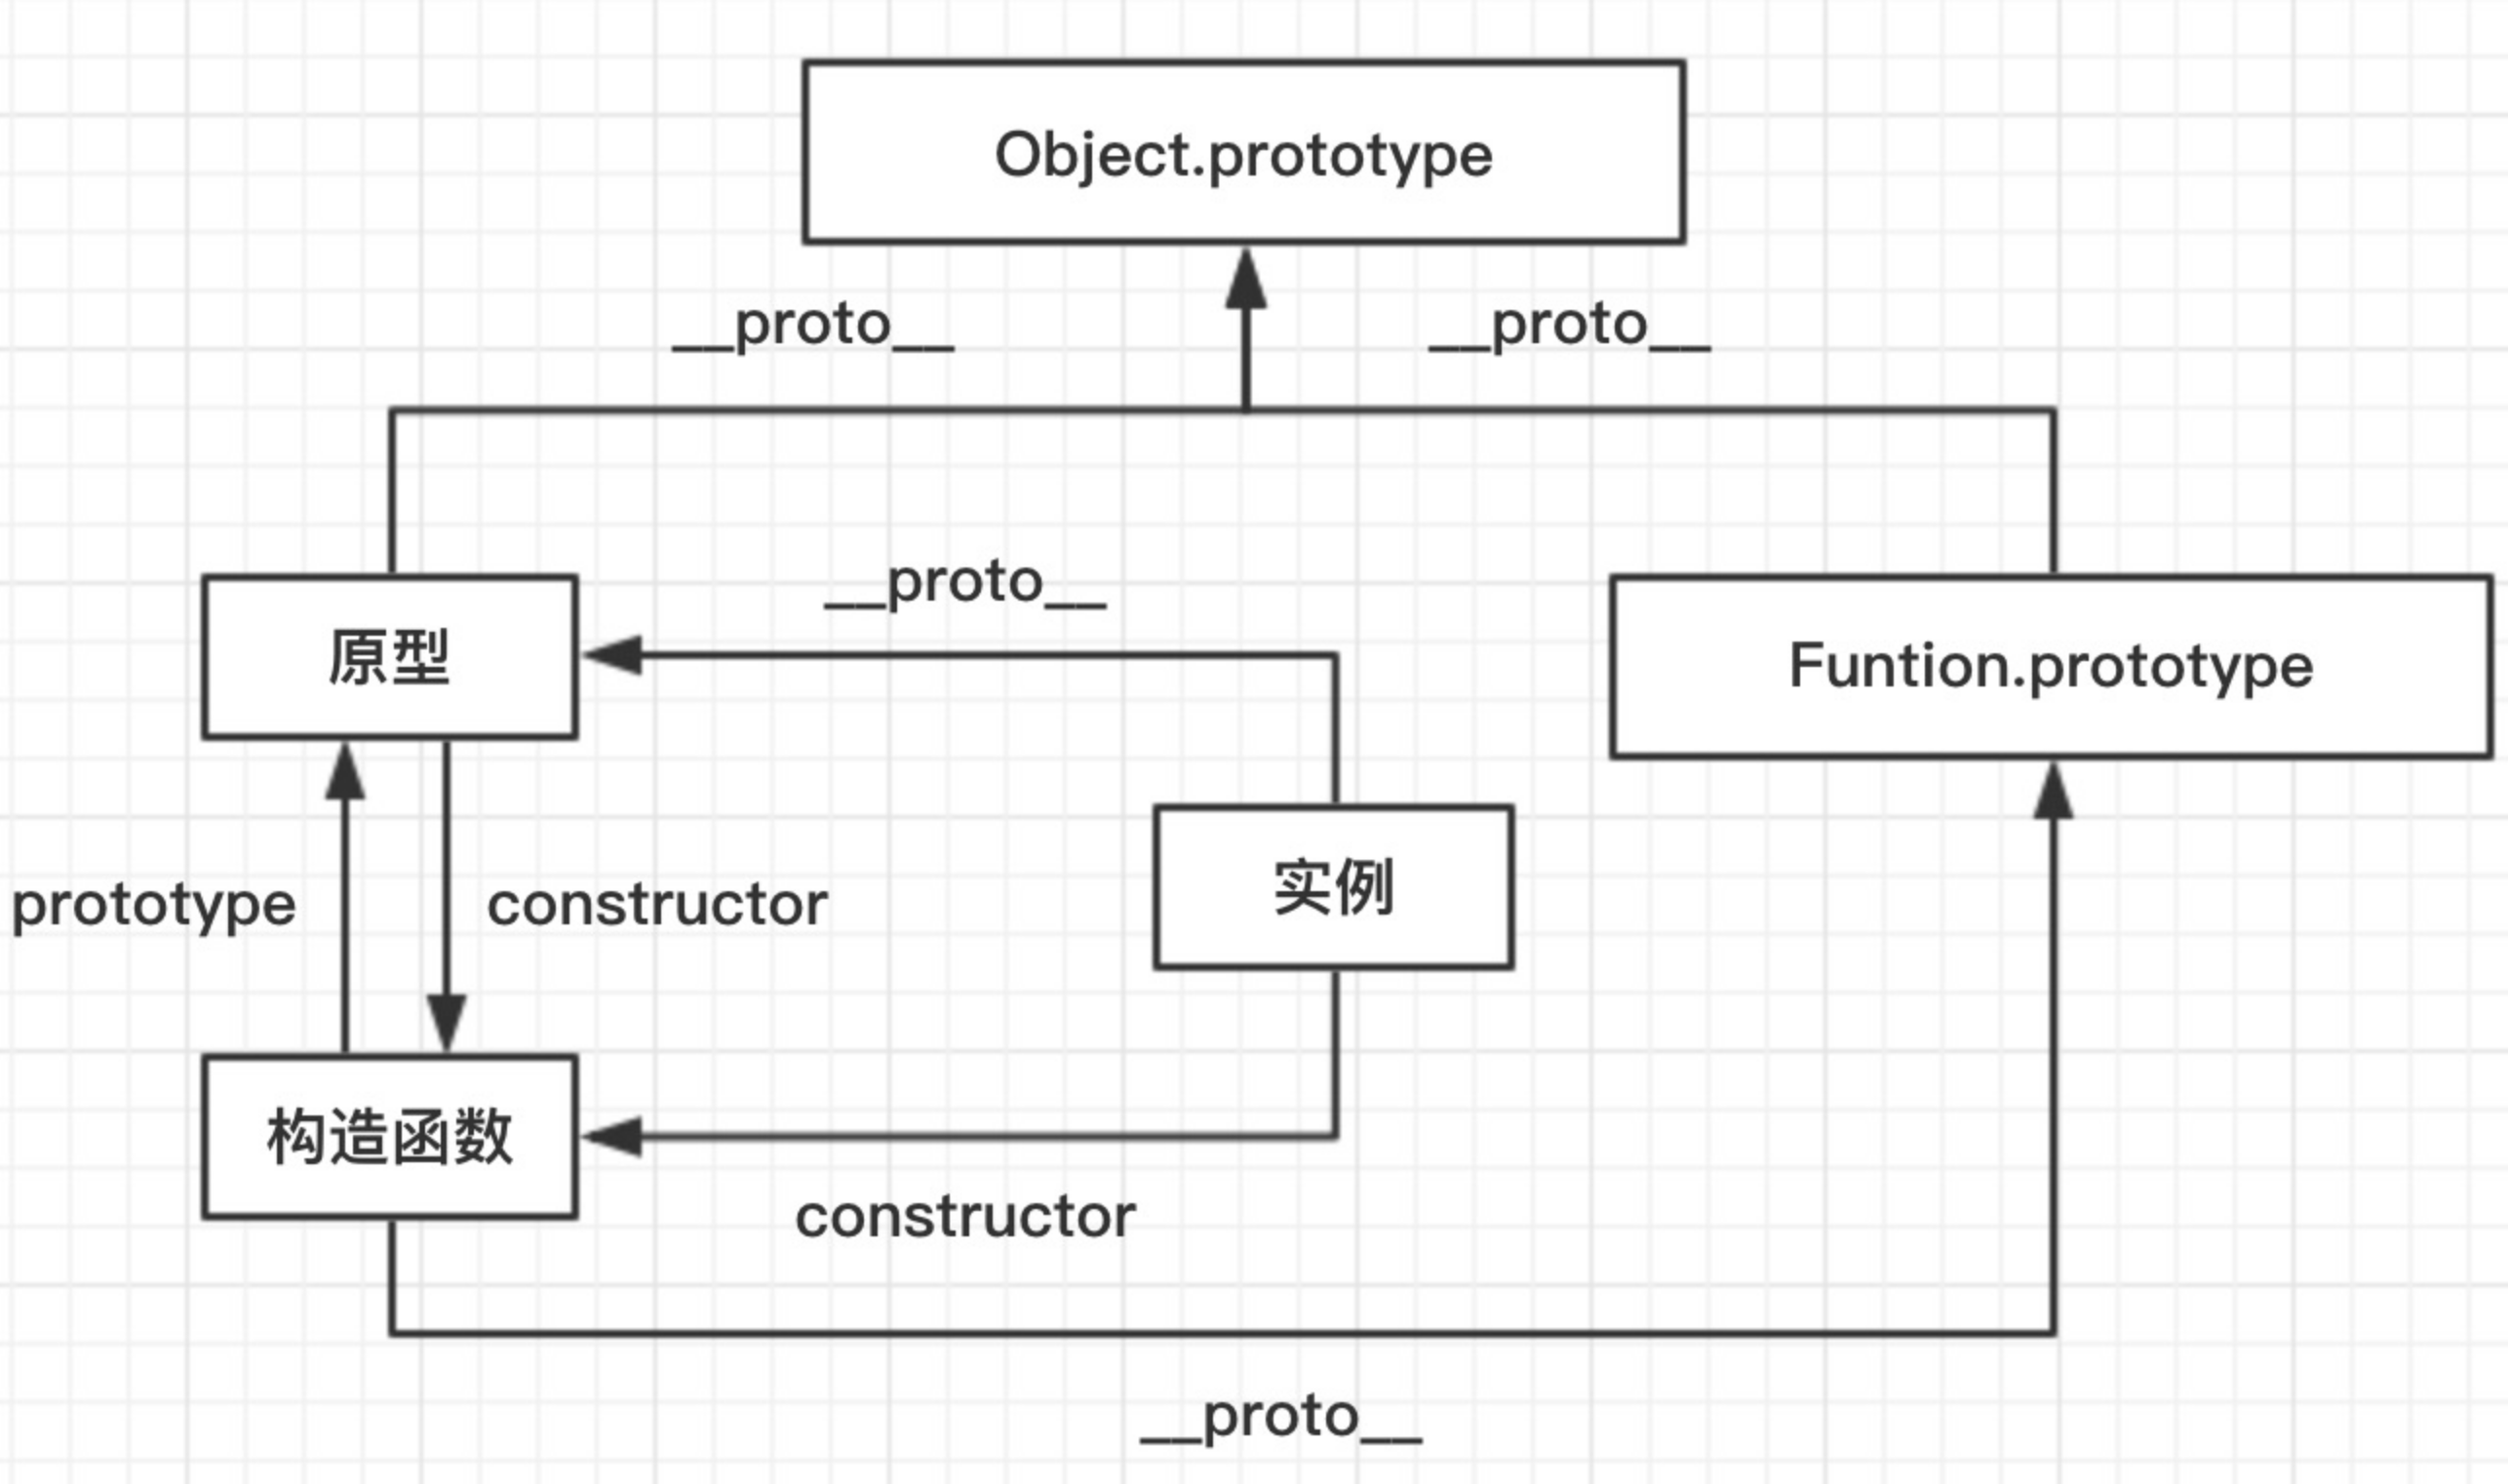
总结:
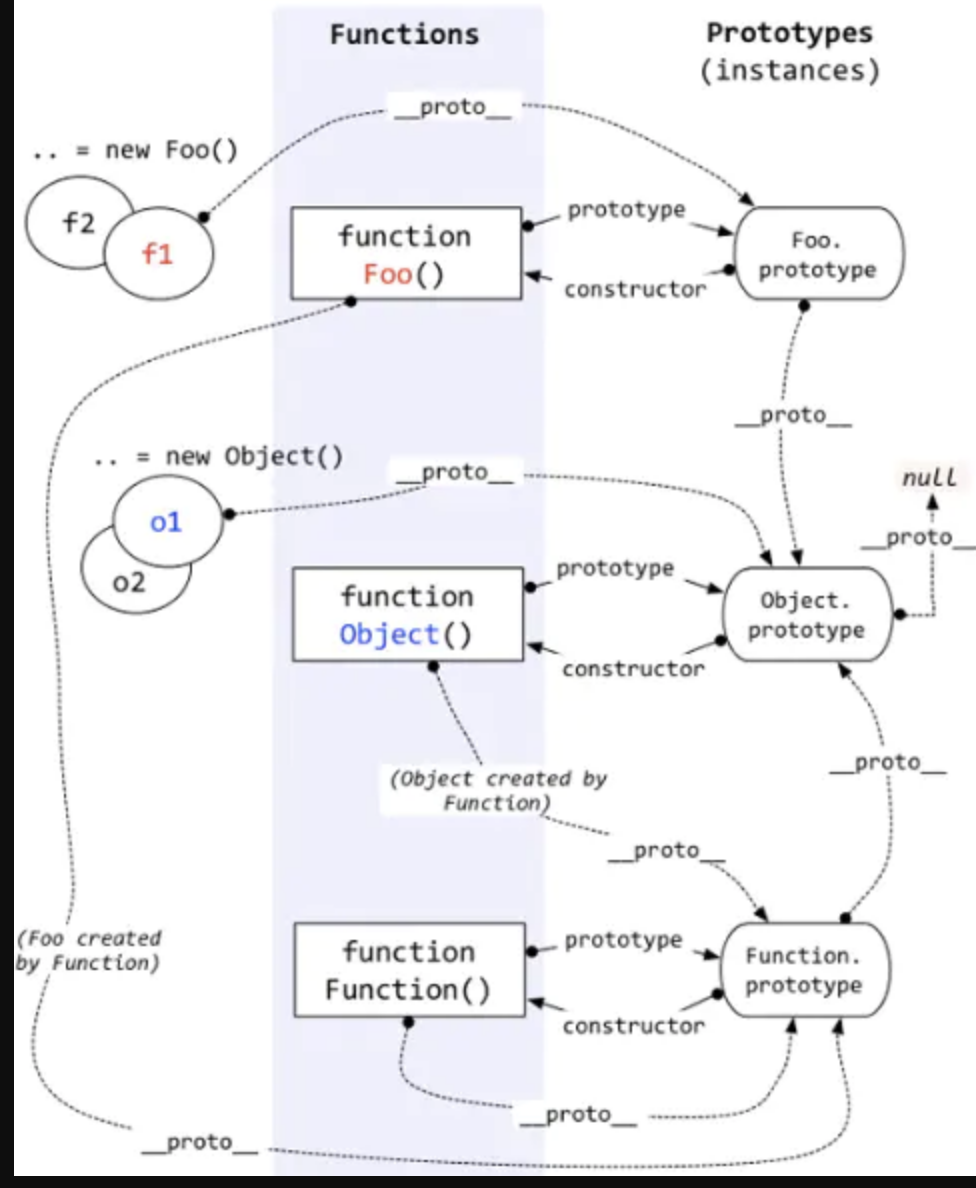
- 每个函数都有
prototype属性,除了Function.prototype.bind(),该属性指向原型。 - 每个对象都有
__proto__属性,指向了创建该对象的构造函数的原型。其实这个属性指向了[[prototype]],但是[[prototype]]是内部属性,我们并不能访问到,所以使用_proto_来访问。 - 对象可以通过
__proto__来寻找不属于该对象的属性,__proto__将对象连接起来组成了原型链。
❤ 继承
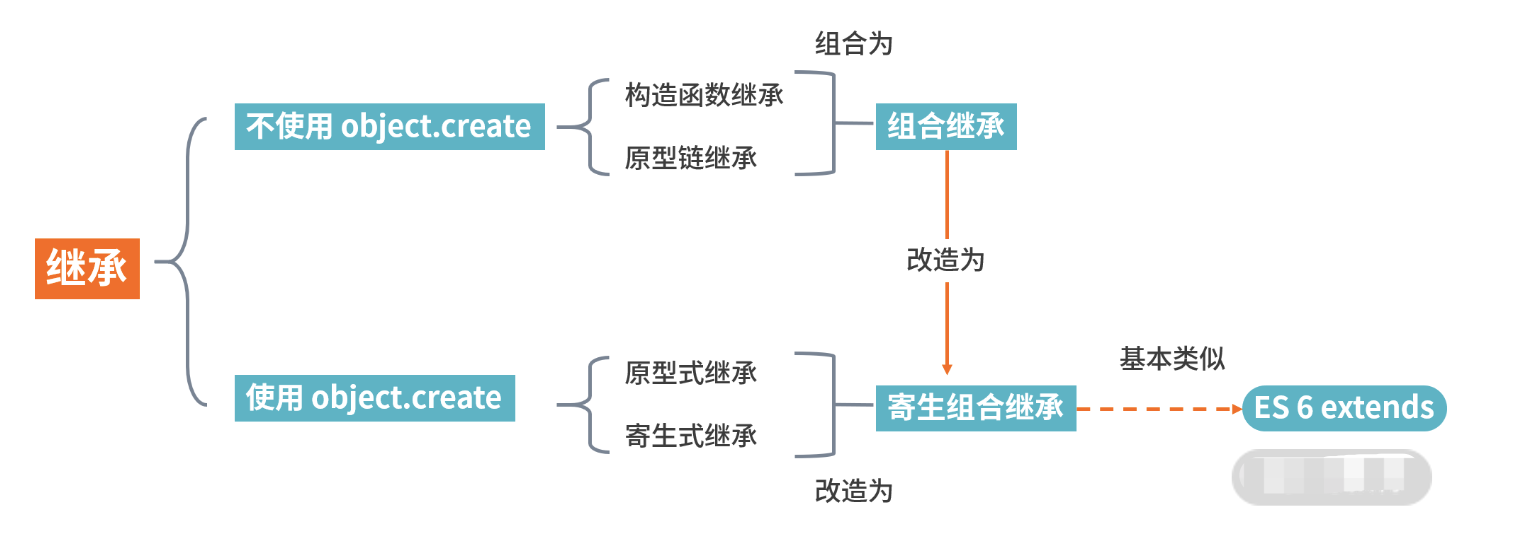
涉及面试题:原型如何实现继承?
Class如何实现继承?Class本质是什么?
首先先来讲下 class,其实在 JS中并不存在类,class 只是语法糖,本质还是函数
1 | class Person {} |
组合继承
组合继承是最常用的继承方式
1 | function Parent(value) { |
以上继承的方式核心是在子类的构造函数中通过
Parent.call(this)继承父类的属性,然后改变子类的原型为new Parent()来继承父类的函数。这种继承方式优点在于构造函数可以传参,不会与父类引用属性共享,可以复用父类的函数,但是也存在一个缺点就是在继承父类函数的时候调用了父类构造函数,导致子类的原型上多了不需要的父类属性,存在内存上的浪费
构造继承
原型继承
实例继承
拷贝继承
原型
prototype机制或apply和call方法去实现较简单,建议使用构造函数与原型混合方式
1 | function Parent(){ |
数据类型
介绍 JS 有哪些内置对象
- 数据封装类对象:
Object、Array、Boolean、Number、String - 其他对象:
Function、Arguments、Math、Date、RegExp、Error - ES6新增对象:
Symbol、Map、Set、Promises、Proxy、Reflect
JS 有几种类型,画一下内存图
- 原始数据类型(
Undefined,Null,Boolean,Number、String)– 栈 - 引用数据类型(对象、数组和函数)– 堆
- 两种类型的区别是:存储位置不同:
- 原始数据类型是直接存储在栈(
stack)中的简单数据段,占据空间小、大小固定,属于被频繁使用数据; - 引用数据类型存储在堆(
heap)中的对象,占据空间大、大小不固定,如果存储在栈中,将会影响程序运行的性能; - 引用数据类型在栈中存储了指针,该指针指向堆中该实体的起始地址。
- 当解释器寻找引用值时,会首先检索其在栈中的地址,取得地址后从堆中获得实体。
❤ JS 基本数据类型 引用数据类型
得分点
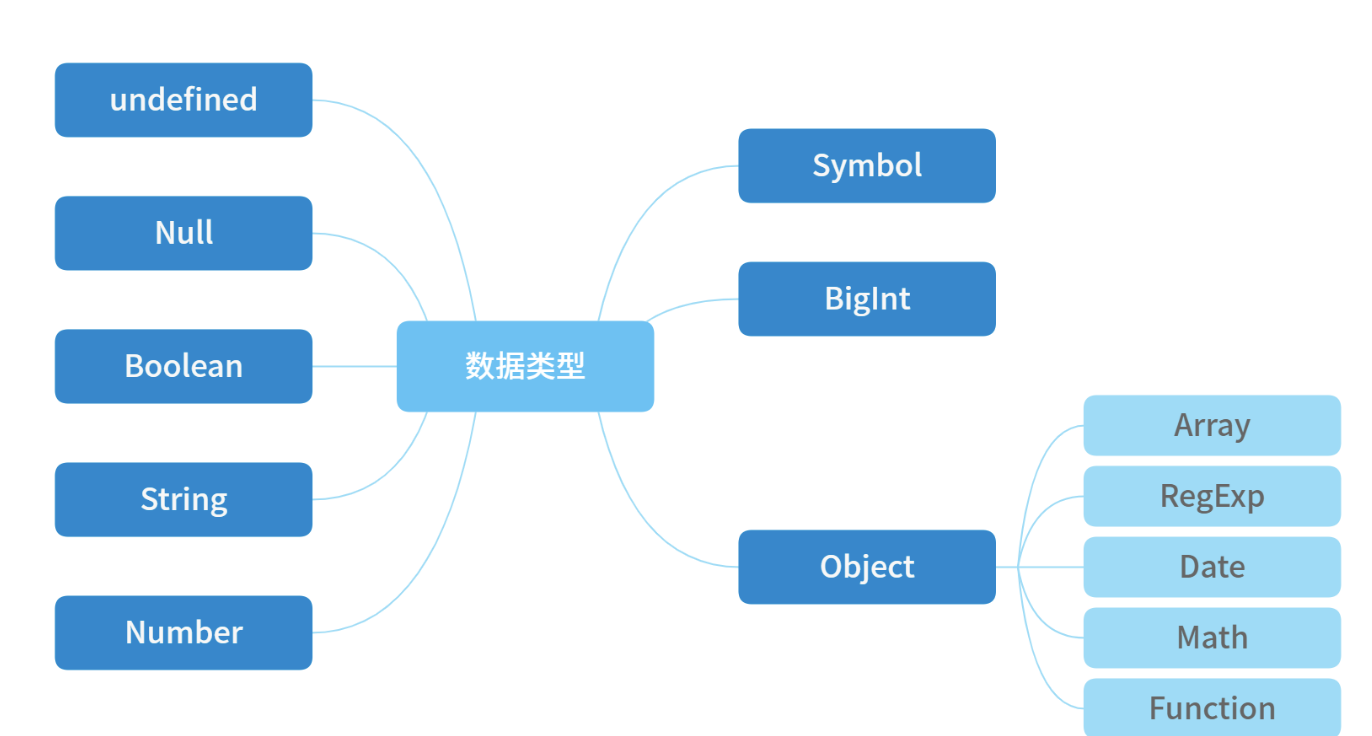
Number、String、Boolean、BigInt、Symbol、Null、Undefined、Object、8种
标准回答
JS数据类型分为两类:
- 一类是基本数据类型,也叫简单数据类型,包含7种类型,分别是
Null、Undefined、Number、String、Boolean、Symbol(es6新增,表示独一无二的值)、BigInt(es10新增)。 - 另一类是引用数据类型也叫复杂数据类型,通常用
Object代表,普通对象,数组Array,正则RegExp,日期Date,数学Math,函数Function都属于Object。
- 一类是基本数据类型,也叫简单数据类型,包含7种类型,分别是
数据分成两大类的本质区别:基本数据类型和引用数据类型它们在内存中的存储方式不同。
- 基本数据类型是直接存储在栈中的简单数据段,占据空间小,属于被频繁使用的数据。
- 引用数据类型是存储在堆内存中,占据空间大。引用数据类型在栈中存储了指针,该指针指向堆中该实体的起始地址,当解释器寻找引用值时,会检索其在栈中的地址,取得地址后从堆中获得实体。
加分回答
Symbol是ES6新出的一种数据类型,这种数据类型的特点就是没有重复的数据,可以作为object的key。
数据的创建方法Symbol(),因为它的构造函数不够完整,所以不能使用new Symbol()创建数据。由于Symbol()创建数据具有唯一性,所以 Symbol() !== Symbol(), 同时使用Symbol数据作为key不能使用for获取到这个key,需要使用Object.getOwnPropertySymbols(obj)获得这个obj对象中key类型是Symbol的key值。
1 | let key = Symbol('key'); |
BigInt也是ES6新出的一种数据类型,这种数据类型的特点就是数据涵盖的范围大,能够解决超出普通数据类型范围报错的问题。
使用方法:
- 整数末尾直接+n:647326483767797n
- 调用BigInt()构造函数:BigInt(“647326483767797”)
注意:BigInt和Number之间不能进行混合操作
❤ JS 判断变量的类型
- 得分点:
typeof、instanceof、Object.prototype.toString.call()(对象原型链判断方法)、constructor(用于引用数据类型) - 标准回答: JS 有4种方法判断变量的类型,分别是
typeof、instanceof、Object.prototype.toString.call()(对象原型链判断方法)、constructor(用于引用数据类型)typeof:常用于判断基本数据类型,对于引用数据类型除了function返回’function‘,其余全部返回’object'。instanceof:主要用于区分引用数据类型,检测方法是检测的类型在当前实例的原型链上,用其检测出来的结果都是true,不太适合用于简单数据类型的检测,检测过程繁琐且对于简单数据类型中的undefined, null, symbol检测不出来。constructor:用于检测引用数据类型,检测方法是获取实例的构造函数判断和某个类是否相同,如果相同就说明该数据是符合那个数据类型的,这种方法不会把原型链上的其他类也加入进来,避免了原型链的干扰。Object.prototype.toString.call():适用于所有类型的判断检测,检测方法是Object.prototype.toString.call(数据)返回的是该数据类型的字符串。 这四种判断数据类型的方法中,各种数据类型都能检测且检测精准的就是Object.prototype.toString.call()这种方法。
- 加分回答:
instanceof的实现原理:验证当前类的原型prototype是否会出现在实例的原型链__proto__上,只要在它的原型链上,则结果都为true。因此,instanceof在查找的过程中会遍历左边变量的原型链,直到找到右边变量的prototype,找到返回true,未找到返回false。Object.prototype.toString.call()原理:Object.prototype.toString表示一个返回对象类型的字符串,call()方法可以改变this的指向,那么把Object.prototype.toString()方法指向不同的数据类型上面,返回不同的结果
(1)typeof
typeof 对于原始类型来说,除了 null 都可以显示正确的类型
1 | console.log(typeof 2); // number |
typeof对于对象来说,除了函数都会显示object,所以说typeof并不能准确判断变量到底是什么类型,所以想判断一个对象的正确类型,这时候可以考虑使用instanceof
(2)instanceof
instanceof
可以正确的判断对象的类型,因为内部机制是通过判断对象的原型链中是不是能找到类型的prototype
1 | console.log(2 instanceof Number); // false |
instanceof可以准确地判断复杂引用数据类型,但是不能正确判断基础数据类型;- 而
typeof也存在弊端,它虽然可以判断基础数据类型(null除外),但是引用数据类型中,除了function类型以外,其他的也无法判断
1 | // 我们也可以试着实现一下 instanceof |
(3)constructor
1 | console.log((2).constructor === Number); // true |
这里有一个坑,如果我创建一个对象,更改它的原型,
constructor就会变得不可靠了
1 | function Fn(){}; |
(4)Object.prototype.toString.call()
toString()是Object的原型方法,调用该方法,可以统一返回格式为“[object Xxx]”的字符串,其中Xxx就是对象的类型。对于Object对象,直接调用toString()就能返回[object Object];而对于其他对象,则需要通过call来调用,才能返回正确的类型信息。我们来看一下代码。
1 | Object.prototype.toString({}) // "[object Object]" |
实现一个全局通用的数据类型判断方法,来加深你的理解,代码如下
1 | function getType(obj){ |
小结
typeof- 直接在计算机底层基于数据类型的值(二进制)进行检测
typeof null为object原因是对象存在在计算机中,都是以000开始的二进制存储,所以检测出来的结果是对象typeof普通对象/数组对象/正则对象/日期对象 都是objecttypeof NaN === 'number'
instanceof- 检测当前实例是否属于这个类的
- 底层机制:只要当前类出现在实例的原型上,结果都是true
- 不能检测基本数据类型
constructor- 支持基本类型
- constructor可以随便改,也不准
Object.prototype.toString.call([val])- 返回当前实例所属类信息
判断
Target的类型,单单用typeof并无法完全满足,这其实并不是bug,本质原因是JS的万物皆对象的理论。因此要真正完美判断时,我们需要区分对待:
- 基本类型(
null): 使用String(null) - 基本类型(
string / number / boolean / undefined) +function: - 直接使用typeof即可 - 其余引用类型(
Array / Date / RegExp Error): 调用toString后根据[object XXX]进行判断
❤ JS 单线程模型
JavaScript语言的一大特点就是单线程,也就是说,同一时间只能做一件事,前面的任务没做完,后面的任务只能等着。
1. 为什么JavaScript是单线程的呢?
- 这主要与JavaScript用途有关。它的主要用途是与用户互动,以及操作DOM。如果JavaScript是多线程的,会带来很多复杂的问题,假如 JavaScript有A和B两个线程,A线程在DOM节点上添加了内容,B线程删除了这个节点,应该是哪个为准呢? 所以,为了避免复杂性,所以设计成了单线程。
- 虽然 HTML5 提出了Web Worker标准。Web Worker 的作用,就是为 JavaScript 创造多线程环境,允许主线程创建 Worker 线程,将一些任务分配给后者运行。但是子线程完全受主线程控制,且不得操作DOM。所以这个并没有改变JavaScript单线程的本质。一般使用 Web Worker 的场景是代码中有很多计算密集型或高延迟的任务,可以考虑分配给 Worker 线程。
- 但是使用的时候一定要注意,worker 线程是为了让你的程序跑的更快,但是如果 worker 线程和主线程之间通信的时间大于了你不使用worker线程的时间,结果就得不偿失了。
2. 浏览器内核中线程之间的关系
- GUI渲染线程和JS引擎线程互斥
- js是可以操作DOM的,如果在修改这些元素的同时渲染页面(js线程和ui线程同时运行),那么渲染线程前后获得的元素数据可能就不一致了。
- JS阻塞页面加载
- js如果执行时间过长就会阻塞页面
3. 浏览器是多进程的优点
- 默认新开 一个 tab 页面 新建 一个进程,所以单个 tab 页面崩溃不会影响到整个浏览器。
- 第三方插件崩溃也不会影响到整个浏览器。
- 多进程可以充分利用现代 CPU 多核的优势。
- 方便使用沙盒模型隔离插件等进程,提高浏览器的稳定性。
4. 进程和线程又是什么呢
进程(process)和线程(thread)是操作系统的基本概念。
- 进程是 CPU 资源分配的最小单位(是能拥有资源和独立运行的最小单位)。
- 线程是 CPU 调度的最小单位(是建立在进程基础上的一次程序运行单位)。
由于每个进程至少要做一件事,所以一个进程至少有一个线程。系统会给每个进程分配独立的内存,因此进程有它独立的资源。同一进程内的各个线程之间共享该进程的内存空间(包括代码段,数据集,堆等)。
进程可以理解为一个工厂不不同车间,相互独立。线程是车间里的工人,可以自己做自己的事情,也可以相互配合做同一件事情。
5. 任务队列
- 单线程就意味着,所有任务都要排队执行,前一个任务结束,才会执行后一个任务。
- 如果一个任务需要执行,但此时JavaScript引擎正在执行其他任务,那么这个任务就需要放到一个队列中进行等待。等到线程空闲时,就可以从这个队列中取出最早加入的任务进行执行(类似于我们去银行排队办理业务,单线程相当于说这家银行只有一个服务窗口,一次只能为一个人服务,后面到的就需要排队,而任务队列就是排队区,先到的就优先服务)
注意: 如果当前线程空闲,并且队列为空,那每次加入队列的函数将立即执行。
为什么会有任务队列? 由于 JS 是单线程的,同步执行任务会造成浏览器的阻塞,所以我们将 JS 分成一个又一个的任务,通过不停的循环来执行事件队列中的任务。
请解释什么是事件代理
- 事件代理(
Event Delegation),又称之为事件委托。是JavaScript中常用绑定事件的常用技巧。顾名思义,“事件代理”即是把原本需要绑定的事件委托给父元素,让父元素担当事件监听的职务。事件代理的原理是DOM元素的事件冒泡。使用事件代理的好处是可以提高性能 - 可以大量节省内存占用,减少事件注册,比如在
table上代理所有td的click事件就非常棒 - 可以实现当新增子对象时无需再次对其绑定
事件模型
W3C中定义事件的发生经历三个阶段:捕获阶段(capturing)、目标阶段(targetin)、冒泡阶段(bubbling)
- 冒泡型事件:当你使用事件冒泡时,子级元素先触发,父级元素后触发
- 捕获型事件:当你使用事件捕获时,父级元素先触发,子级元素后触发
DOM事件流:同时支持两种事件模型:捕获型事件和冒泡型事件- 阻止冒泡:在
W3c中,使用stopPropagation()方法;在IE下设置cancelBubble = true - 阻止捕获:阻止事件的默认行为,例如
click - <a>后的跳转。在W3c中,使用preventDefault()方法,在IE下设置window.event.returnValue = false
❤ 伪数组和数组的区别
- 得分点 类型是object、不能使用数组方法、可以获取长度、可以使用for in遍历
- 标准回答 伪数组它的类型不是Array,而是Object,而数组类型是Array。可以使用的length属性查看长度,也可以使用[index]获取某个元素,但是不能使用数组的其他方法,也不能改变长度,遍历使用
for in方法。- 伪数组的常见场景:
- 函数的参数
arguments - 原生js获取DOM:
document.querySelector('div')等 - jquery获取DOM:
$(“div”)等
- 函数的参数
- 伪数组的常见场景:
- 加分回答
- 伪数组转换成真数组方法
Array.prototype.slice.call(伪数组)[].slice.call(伪数组)Array.from(伪数组)转换后的数组长度由length属性决定。索引不连续时转换结果是连续的,会自动补位。
❤ Ajax原理
Ajax的原理简单来说是在用户和服务器之间加了—个中间层(AJAX引擎),通过XmlHttpRequest对象来向服务器发异步请求,从服务器获得数据,然后用javascript来操作DOM而更新页面。使用户操作与服务器响应异步化。这其中最关键的一步就是从服务器获得请求数据Ajax的过程只涉及JavaScript、XMLHttpRequest和DOM。XMLHttpRequest是ajax的核心机制
1 | /** 1. 创建Ajax对象 **/ |
ajax 有那些优缺点?
- 优点:
- 通过异步模式,提升了用户体验.
- 优化了浏览器和服务器之间的传输,减少不必要的数据往返,减少了带宽占用.
Ajax在客户端运行,承担了一部分本来由服务器承担的工作,减少了大用户量下的服务器负载。Ajax可以实现动态不刷新(局部刷新)
- 缺点:
- 安全问题
AJAX暴露了与服务器交互的细节。 - 对搜索引擎的支持比较弱。
- 不容易调试。
- 安全问题
牛客网解释:
- 得分点 new XMLHttpRequest()、设置请求参数open()、发送请求request.send()、响应request.onreadystatechange
- 标准回答 创建ajax过程:
- 创建XHR对象:new XMLHttpRequest()
- 设置请求参数:request.open(Method, 服务器接口地址);
- 发送请求: request.send(),如果是get请求不需要参数,post请求需要参数request.send(data)
- 监听请求成功后的状态变化:根据状态码进行相应的处理。
1 | XHR.onreadystatechange = function () { |
- 加分回答
- POST请求需要设置请求头 readyState值说明
- 0:初始化,XHR对象已经创建,还未执行open
- 1:载入,已经调用open方法,但是还没发送请求
- 2:载入完成,请求已经发送完成
- 3:交互,可以接收到部分数据
- 4:数据全部返回 status值说明
- 200:成功
- 404:没有发现文件、查询或URl
- 500:服务器产生内部错误
- POST请求需要设置请求头 readyState值说明
模块化开发怎么做?
- 立即执行函数,不暴露私有成员
1 | var module1 = (function(){ |
异步加载JS的方式有哪些?
- 设置
<script>属性 async=”async” (一旦脚本可用,则会异步执行) - 动态创建
script DOM:document.createElement('script'); XmlHttpRequest脚本注入- 异步加载库
LABjs - 模块加载器
Sea.js
❤ 内存泄露
参考链接
Chrome devTools 查看内存情况
- 打开
Chrome的无痕模式,这样做的目的是为了屏蔽掉Chrome插件对我们之后测试内存占用情况的影响- 打开开发者工具,找到
Performance这一栏,可以看到其内部带着一些功能按钮,例如:开始录制按钮;刷新页面按钮;清空记录按钮;记录并可视化js内存、节点、事件监听器按钮;触发垃圾回收机制按钮等

简单录制一下百度页面,看看我们能获得什么,如下动图所示:
从上图中我们可以看到,在页面从零到加载完成这个过程中
JS Heap(js堆内存)、documents(文档)、Nodes(DOM节点)、Listeners(监听器)、GPU memory(GPU内存)的最低值、最高值以及随时间的走势曲线,这也是我们主要关注的点
看看开发者工具中的Memory一栏,其主要是用于记录页面堆内存的具体情况以及js堆内存随加载时间线动态的分配情况

堆快照就像照相机一样,能记录你当前页面的堆内存情况,每快照一次就会产生一条快照记录

如上图所示,刚开始执行了一次快照,记录了当时堆内存空间占用为
33.7MB,然后我们点击了页面中某些按钮,又执行一次快照,记录了当时堆内存空间占用为32.5MB。并且点击对应的快照记录,能看到当时所有内存中的变量情况(结构、占总占用内存的百分比…)

在开始记录后,我们可以看到图中右上角有起伏的蓝色与灰色的柱形图,其中
蓝色表示当前时间线下占用着的内存;灰色表示之前占用的内存空间已被清除释放
在得知有内存泄漏的情况存在时,我们可以改用Memory来更明确得确认问题和定位问题
首先可以用Allocation instrumentation on timeline来确认问题,如下图所示:
内存泄漏的场景
- 闭包使用不当引起内存泄漏
- 全局变量
- 分离的
DOM节点 - 控制台的打印
- 遗忘的定时器
1. 闭包使用不当引起内存泄漏
使用Performance和Memory来查看一下闭包导致的内存泄漏问题
1 | <button onclick="myClick()">执行fn1函数</button> |
在退出
fn1函数执行上下文后,该上下文中的变量a本应被当作垃圾数据给回收掉,但因fn1函数最终将变量a返回并赋值给全局变量res,其产生了对变量a的引用,所以变量a被标记为活动变量并一直占用着相应的内存,假设变量res后续用不到,这就算是一种闭包使用不当的例子
2. 全局变量
全局的变量一般是不会被垃圾回收掉的当然这并不是说变量都不能存在全局,只是有时候会因为疏忽而导致某些变量流失到全局,例如未声明变量,却直接对某变量进行赋值,就会导致该变量在全局创建,如下所示:
1 | function fn1() { |
- 此时这种情况就会在全局自动创建一个变量
name,并将一个很大的数组赋值给name,又因为是全局变量,所以该内存空间就一直不会被释放 - 解决办法的话,自己平时要多加注意,不要在变量未声明前赋值,或者也可以
开启严格模式,这样就会在不知情犯错时,收到报错警告,例如
1 | function fn1() { |
3. 分离的DOM节点
假设你手动移除了某个dom节点,本应释放该dom节点所占用的内存,但却因为疏忽导致某处代码仍对该被移除节点有引用,最终导致该节点所占内存无法被释放,例如这种情况
1 | <div id="root"> |
该代码所做的操作就是点击按钮后移除
.child的节点,虽然点击后,该节点确实从dom被移除了,但全局变量child仍对该节点有引用,所以导致该节点的内存一直无法被释放,可以尝试用Memory的快照功能来检测一下
同样的先记录一下初始状态的快照,然后点击移除按钮后,再点击一次快照,此时内存大小我们看不出什么变化,因为移除的节点占用的内存实在太小了可以忽略不计,但我们可以点击第二条快照记录,在筛选框里输入
detached,于是就会展示所有脱离了却又未被清除的节点对象
解决办法如下图所示:
1 | <div id="root"> |
改动很简单,就是将对
.child节点的引用移动到了click事件的回调函数中,那么当移除节点并退出回调函数的执行上文后就会自动清除对该节点的引用,那么自然就不会存在内存泄漏的情况了,我们来验证一下
结果很明显,这样处理过后就不存在内存泄漏的情况了
4. 控制台的打印
1 | <button>按钮</button> |
我们在按钮的点击回调事件中创建了一个很大的数组对象并打印,用performance来验证一下
开始录制,先触发一次垃圾回收清除初始的内存,然后点击三次按钮,即执行了三次点击事件,最后再触发一次垃圾回收。查看录制结果发现
JS Heap曲线成阶梯上升,并且最终保持的高度比初始基准线高很多,这说明每次执行点击事件创建的很大的数组对象obj都因为console.log被浏览器保存了下来并且无法被回收
接下来注释掉console.log,再来看一下结果:
1 | <button>按钮</button> |
可以看到没有打印以后,每次创建的obj都立马被销毁了,并且最终触发垃圾回收机制后跟初始的基准线同样高,说明已经不存在内存泄漏的现象了
其实同理 console.log也可以用Memory来进一步验证
最后简单总结一下:在开发环境下,可以使用控制台打印便于调试,但是在生产环境下,尽可能得不要在控制台打印数据。所以我们经常会在代码中看到类似如下的操作:
1 | // 如果在开发环境下,打印变量obj |
这样就避免了生产环境下无用的变量打印占用一定的内存空间,同样的除了
console.log之外,console.error、console.info、console.dir等等都不要在生产环境下使用
5. 遗忘的定时器
定时器也是平时很多人会忽略的一个问题,比如定义了定时器后就再也不去考虑清除定时器了,这样其实也会造成一定的内存泄漏。来看一个代码示例:
1 | <button>开启定时器</button> |
这段代码是在点击按钮后执行fn1函数,fn1函数内创建了一个很大的数组对象largeObj,同时创建了一个setInterval定时器,定时器的回调函数只是简单的引用了一下变量largeObj,我们来看看其整体的内存分配情况吧:
按道理来说点击按钮执行fn1函数后会退出该函数的执行上下文,紧跟着函数体内的局部变量应该被清除,但图中performance的录制结果显示似乎是存在内存泄漏问题的,即最终曲线高度比基准线高度要高,那么再用Memory来确认一次:
- 在我们点击按钮后,从动态内存分配的图上看到出现一个蓝色柱形,说明浏览器为变量
largeObj分配了一段内存,但是之后这段内存并没有被释放掉,说明的确存在内存泄漏的问题,原因其实就是因为setInterval的回调函数内对变量largeObj有一个引用关系,而定时器一直未被清除,所以变量largeObj的内存也自然不会被释放 - 那么我们如何来解决这个问题呢,假设我们只需要让定时器执行三次就可以了,那么我们可以改动一下代码:
1 | <button>开启定时器</button> |
现在我们再通过performance和memory来看看还不会存在内存泄漏的问题
performance
这次的录制结果就能看出,最后的曲线高度和初始基准线的高度一样,说明并没有内存泄漏的情况
memory
这里做一个解释,图中刚开始出现的蓝色柱形是因为我在录制后刷新了页面,可以忽略;然后我们点击了按钮,看到又出现了一个蓝色柱形,此时就是为fn1函数中的变量largeObj分配了内存,3s后该内存又被释放了,即变成了灰色柱形。所以我们可以得出结论,这段代码不存在内存泄漏的问题
简单总结一下: 大家在平时用到了定时器,如果在用不到定时器后一定要清除掉,否则就会出现本例中的情况。除了
setTimeout和setInterval,其实浏览器还提供了一个API也可能就存在这样的问题,那就是requestAnimationFrame
JS 内存泄漏 整合
JavaScript 内存泄露指对象在不需要使用它时仍然存在,导致占用的内存不能使用或回收
- 未使用 var 声明的全局变量
- 闭包函数(Closures)
- 循环引用(两个对象相互引用)
- 控制台日志(console.log)
- 移除存在绑定事件的DOM元素(IE)
setTimeout的第一个参数使用字符串而非函数的话,会引发内存泄漏- 垃圾回收器定期扫描对象,并计算引用了每个对象的其他对象的数量。如果一个对象的引用数量为 0(没有其他对象引用过该对象),或对该对象的唯一引用是循环的,那么该对象的内存即可回收
❤ null,undefined 的区别,如何让一个属性变为null
undefined表示不存在这个值。undefined:是一个表示”无”的原始值或者说表示”缺少值”,就是此处应该有一个值,但是还没有定义。当尝试读取时会返回undefined- 例如变量被声明了,但没有赋值时,就等于
undefined null表示一个对象被定义了,值为“空值”null: 是一个对象(空对象, 没有任何属性和方法)- 例如作为函数的参数,表示该函数的参数不是对象;
- 在验证
null时,一定要使用===,因为==无法分别null和undefined
- 得分点:操作的变量没有被赋值、全局对象的一个属性、函数没有return返回值、值
null特指对象的值未设置 undefined == null、undefined !== null - 标准回答:
- undefind 是全局对象的一个属性,当一个变量没有被赋值或者一个函数没有返回值或者某个对象不存在某个属性却去访问或者函数定义了形参但没有传递实参,这时候都是undefined。undefined通过typeof判断类型是’undefined’。undefined == undefined undefined === undefined 。
- null代表对象的值未设置,相当于一个对象没有设置指针地址就是null。null通过typeof判断类型是’object’。null === null null == null null == undefined null !== undefined undefined 表示一个变量初始状态值,而 null 则表示一个变量被人为的设置为空对象,而不是原始状态。在实际使用过程中,不需要对一个变量显式的赋值 undefined,当需要释放一个对象时,直接赋值为 null 即可。 让一个变量为null,直接给该变量赋值为null即可。
- 加分回答: null 其实属于自己的类型 Null,而不属于Object类型,typeof 之所以会判定为 Object 类型,是因为JavaScript 数据类型在底层都是以二进制的形式表示的,二进制的前三位为 0 会被 typeof 判断为对象类型,而 null 的二进制位恰好都是 0 ,因此,null 被误判断为 Object 类型。 对象被赋值了null 以后,对象对应的堆内存中的值就是游离状态了,GC 会择机回收该值并释放内存。因此,需要释放某个对象,就将变量设置为 null,即表示该对象已经被清空,目前无效状态。
❤ 垃圾回收
- 得分点 栈垃圾回收、堆垃圾回收、新生区老生区、Scavenge算法、标记-清除算法、标记-整理算法、全停顿、增量标记
- 标准回答 浏览器垃圾回收机制根据数据的存储方式分为栈垃圾回收和堆垃圾回收。
- 栈垃圾回收的方式非常简便,当一个函数执行结束之后,JavaScript 引擎会通过向下移动 ESP 来销毁该函数保存在栈中的执行上下文,遵循先进后出的原则。
- 堆垃圾回收,当函数直接结束,栈空间处理完成了,但是堆空间的数据虽然没有被引用,但是还是存储在堆空间中,需要垃圾回收器将堆空间中的垃圾数据回收。
- 为了使垃圾回收达到更好的效果,根据对象的生命周期不一样,使用不同的垃圾回收的算法。在 V8 中会把堆分为新生代和老生代两个区域,新生代中存放的是生存时间短的对象,老生代中存放的生存时间久的对象。
- 新生区中使用Scavenge算法,老生区中使用标记-清除算法和标记-整理算法。
- 加分回答
- Scavenge算法:
- 标记:对对象区域中的垃圾进行标记
- 清除垃圾数据和整理碎片化内存:副垃圾回收器会把这些存活的对象复制到空闲区域中,并且有序的排列起来,复制后空闲区域就没有内存碎片了
- 角色翻转:完成复制后,对象区域与空闲区域进行角色翻转,也就是原来的对象区域变成空闲区域,原来的空闲区域变成了对象区域,这样就完成了垃圾对象的回收操作,同时这种角色翻转的操作还能让新生代中的这两块区域无限重复使用下去
- 标记-清除算法:
- 标记:标记阶段就是从一组根元素开始,递归遍历这组根元素,在这个遍历过程中,能到达的元素称为活动对象,没有到达的元素就可以判断为垃圾数据。
- 清除:将垃圾数据进行清除。
- 产生内存碎片:对一块内存多次执行标记 - 清除算法后,会产生大量不连续的内存碎片。而碎片过多会导致大对象无法分配到足够的连续内存。
- 标记-整理算法
- 标记:和标记 - 清除的标记过程一样,从一组根元素开始,递归遍历这组根元素,在这个遍历过程中,能到达的元素标记为活动对象。
- 整理:让所有存活的对象都向内存的一端移动
- 清除:清理掉端边界以外的内存 V8 是使用副垃圾回收器和主垃圾回收器处理垃圾回收的,不过由于 JavaScript 是运行在主线程之上的,一旦执行垃圾回收算法,都需要将正在执行的 JavaScript 脚本暂停下来,待垃圾回收完毕后再恢复脚本执行。我们把这种行为叫做全停顿。 为了降低老生代的垃圾回收而造成的卡顿,V8 将标记过程分为一个个的子标记过程,同时让垃圾回收标记和 JavaScript 应用逻辑交替进行,直到标记阶段完成,我们把这个算法称为增量标记(Incremental Marking)算法
Javascript垃圾回收方法
- 标记清除(mark and sweep)
- 这是JavaScript最常见的垃圾回收方式,当变量进入执行环境的时候,比如函数中声明一个变量,垃圾回收器将其标记为“进入环境”,当变量离开环境的时候(函数执行结束)将其标记为“离开环境”
- 垃圾回收器会在运行的时候给存储在内存中的所有变量加上标记,然后去掉环境中的变量以及被环境中变量所引用的变量(闭包),在这些完成之后仍存在标记的就是要删除的变量了
引用计数(reference counting)
在低版本IE中经常会出现内存泄露,很多时候就是因为其采用引用计数方式进行垃圾回收。引用计数的策略是跟踪记录每个值被使用的次数,当声明了一个 变量并将一个引用类型赋值给该变量的时候这个值的引用次数就加1,如果该变量的值变成了另外一个,则这个值得引用次数减1,当这个值的引用次数变为0的时 候,说明没有变量在使用,这个值没法被访问了,因此可以将其占用的空间回收,这样垃圾回收器会在运行的时候清理掉引用次数为0的值占用的空间
垃圾回收
找出那些不再继续使用的变 量,然后释放其占用的内存。为此,垃圾收集器会按照固定的时间间隔(或代码执行中预定的收集时间), 周期性地执行这一操作。
标记清除
先所有都加上标记,再把环境中引用到的变量去除标记。剩下的就是没用的了
引用计数
跟踪记录每 个值被引用的次数。清除引用次数为0的变量 ⚠️会有循环引用问题 。循环引用如果大量存在就会导致内存泄露。
let 与 var的区别
let命令不存在变量提升,如果在let前使用,会导致报错- 如果块区中存在
let和const命令,就会形成封闭作用域 - 不允许重复声明,因此,不能在函数内部重新声明参数
let var const
let
- 允许你声明一个作用域被限制在块级中的变量、语句或者表达式
- let绑定不受变量提升的约束,这意味着let声明不会被提升到当前
- 该变量处于从块开始到初始化处理的“暂存死区”
var
- 声明变量的作用域限制在其声明位置的上下文中,而非声明变量总是全局的
- 由于变量声明(以及其他声明)总是在任意代码执行之前处理的,所以在代码中的任意位置声明变量总是等效于在代码开头声明
const
- 声明创建一个值的只读引用 (即指针)
- 基本数据当值发生改变时,那么其对应的指针也将发生改变,故造成
const申明基本数据类型时 - 再将其值改变时,将会造成报错, 例如
const a = 3;a = 5时 将会报错 - 但是如果是复合类型时,如果只改变复合类型的其中某个
Value项时, 将还是正常使用
❤ map 与 forEach的区别
forEach方法,是最基本的方法,就是遍历与循环,默认有3个传参:分别是遍历的数组内容item、数组索引index、和当前遍历数组Arraymap方法,基本用法与forEach一致,但是不同的,它会返回一个新的数组,所以在callback需要有return值,如果没有,会返回undefined
- 得分点 map创建新数组、map返回处理后的值、forEach()不修改原数组、forEach()方法返回undefined
- 标准回答
- map 和 forEach 的区别:
- map有返回值,可以开辟新空间,return出来一个length和原数组一致的数组,即便数组元素是undefined或者是null。forEach默认无返回值,返回结果为undefined,可以通过在函数体内部使用索引修改数组元素。
- map 和 forEach 的区别:
- 加分回答 map的处理速度比forEach快,而且返回一个新的数组,方便链式调用其他数组新方法,比如filter、reduce
1 | let arr = [1, 2, 3, 4, 5]; |
谈一谈你理解的函数式编程
- 简单说,”函数式编程”是一种”编程范式”(programming paradigm),也就是如何编写程序的方法论
- 它具有以下特性:闭包和高阶函数、惰性计算、递归、函数是”第一等公民”、只用”表达式”
❤ JS 实现异步编程的方法
- 回调函数
- 优点:简单、容易理解
- 缺点:不利于维护,代码耦合高
- 事件监听(采用时间驱动模式,取决于某个事件是否发生):
- 优点:容易理解,可以绑定多个事件,每个事件可以指定多个回调函数
- 缺点:事件驱动型,流程不够清晰
- 发布/订阅(观察者模式)
- 类似于事件监听,但是可以通过‘消息中心’,了解现在有多少发布者,多少订阅者
- Promise对象
- 优点:可以利用then方法,进行链式写法;可以书写错误时的回调函数;
- 缺点:编写和理解,相对比较难
- Generator函数
- 优点:函数体内外的数据交换、错误处理机制
- 缺点:流程管理不方便
- async函数
- 优点:内置执行器、更好的语义、更广的适用性、返回的是Promise、结构清晰。
- 缺点:错误处理机制
- 得分点: 回调函数、事件监听、setTimeout、Promise、生成器Generators/yield、async/awt
- 标准回答: 所有异步任务都是在同步任务执行结束之后,从任务队列中依次取出执行。
- 回调函数是异步操作最基本的方法,比如AJAX回调,回调函数的优点是简单、容易理解和实现,缺点是不利于代码的阅读和维护,各个部分之间高度耦合,使得程序结构混乱、流程难以追踪(尤其是多个回调函数嵌套的情况),而且每个任务只能指定一个回调函数。此外它不能使用 try catch 捕获错误,不能直接 return Promise包装了一个异步调用并生成一个Promise实例,当异步调用返回的时候根据调用的结果分别调用实例化时传入的resolve 和 reject方法,then接收到对应的数据,做出相应的处理。
- Promise对象不仅能够捕获错误,而且也很好地解决了回调地狱的问题,缺点是无法取消 Promise,错误需要通过回调函数捕获。
- Generator 函数是 ES6 提供的一种异步编程解决方案,Generator 函数是一个状态机,封装了多个内部状态,可暂停函数, yield可暂停,next方法可启动,每次返回的是yield后的表达式结果。优点是异步语义清晰,缺点是手动迭代
Generator函数很麻烦,实现逻辑有点绕 - async/awt是基于Promise实现的,async/awt使得异步代码看起来像同步代码,所以优点是,使用方法清晰明了,缺点是awt 将异步代码改造成了同步代码,如果多个异步代码没有依赖性却使用了 awt 会导致性能上的降低,代码没有依赖性的话,完全可以使用 Promise.all 的方式。
- 加分回答: JS 异步编程进化史:callback -> promise -> generator/yield -> async/awt。 async/awt函数对 Generator 函数的改进,体现在以下三点:
- 内置执行器。 Generator 函数的执行必须靠执行器,而 async 函数自带执行器。也就是说,async 函数的执行,与普通函数一模一样,只要一行。
- 更广的适用性。 yield 命令后面只能是 Thunk 函数或 Promise 对象,而 async 函数的 awt 命令后面,可以跟 Promise 对象和原始类型的值(数值、字符串和布尔值,但这时等同于同步操作)。
- 更好的语义。 async 和 awt,比起星号和 yield,语义更清楚了。async 表示函数里有异步操作,awt 表示紧跟在后面的表达式需要等待结果。 目前使用很广泛的就是promise和async/awt
❤ 数组去重方法总结
方法二、利用for嵌套for,然后splice去重(ES5中最常用)
1 | function unique(arr){ |
- 双层循环,外层循环元素,内层循环时比较值。值相同时,则删去这个值。
- 想快速学习更多常用的
ES6语法
方法三、利用indexOf去重
1 | function unique(arr) { |
新建一个空的结果数组,
for循环原数组,判断结果数组是否存在当前元素,如果有相同的值则跳过,不相同则push进数组
方法四、利用sort()
1 | function unique(arr) { |
利用
sort()排序方法,然后根据排序后的结果进行遍历及相邻元素比对
方法六、利用includes
1 | function unique(arr) { |
方法七、利用hasOwnProperty
1 | function unique(arr) { |
利用
hasOwnProperty判断是否存在对象属性
方法九、利用递归去重
1 | function unique(arr) { |
方法十、利用Map数据结构去重
1 | function arrayNonRepeatfy(arr) { |
创建一个空
Map数据结构,遍历需要去重的数组,把数组的每一个元素作为key存到Map中。由于Map中不会出现相同的key值,所以最终得到的就是去重后的结果
得分点: 对象属性、new Set() 、indexOf、hasOwnProperty、reduce+includes、filter
标准回答:
利用对象属性key排除重复项:遍历数组,每次判断对象中是否存在该属性,不存在就存储在新数组中,并且把数组元素作为key,设置一个值,存储在对象中,最后返回新数组。这个方法的优点是效率较高,缺点是占用了较多空间,使用的额外空间有一个查询对象和一个新的数组
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20function unique(arr) {
if (!Array.isArray(arr)) {
console.log('type error!')
return
}
var arrry= [];
var obj = {};
for (var i = 0; i < arr.length; i++) {
if (!obj[arr[i]]) {
arrry.push(arr[i])
obj[arr[i]] = 1
} else {
obj[arr[i]]++
}
}
return arrry;
}
var arr = [1,1,'true','true',true,true,15,15,false,false, undefined,undefined, null,null, NaN, NaN,'NaN', 0, 0, 'a', 'a',{},{}];
console.log(unique(arr))
//[1, "true", 15, false, undefined, null, NaN, 0, "a", {…}] //两个true直接去掉了,NaN和{}去重利用Set类型数据无重复项:new 一个 Set,参数为需要去重的数组,Set 会自动删除重复的元素,再将 Set 转为数组返回。这个方法的优点是效率更高,代码简单,思路清晰(ES6中最常用),缺点是可能会有兼容性问题
1
2
3
4
5
6
7
8
9function unique (arr) {
return Array.from(new Set(arr))
}
var arr = [1,1,'true','true',true,true,15,15,false,false, undefined,undefined, null,null, NaN, NaN,'NaN', 0, 0, 'a', 'a',{},{}];
console.log(unique(arr))
//[1, "true", true, 15, false, undefined, null, NaN, "NaN", 0, "a", {}, {}]
[...new Set(arr)]
//代码就是这么少----(其实,严格来说并不算是一种,相对于第一种方法来说只是简化了代码)filter+indexof 去重:这个方法和第一种方法类似,利用 Array 自带的 filter 方法,返回 arr.indexOf(num) 等于 index 的num。原理就是 indexOf 会返回最先找到的数字的索引,假设数组是 [1, 1],在对第二个1使用 indexOf 方法时,返回的是第一个1的索引0。这个方法的优点是可以在去重的时候插入对元素的操作,可拓展性强。
1
2
3
4
5
6
7
8
9function unique(arr) {
return arr.filter(function(item, index, arr) {
//当前元素,在原始数组中的第一个索引==当前索引值,否则返回当前元素
return arr.indexOf(item, 0) === index;
});
}
var arr = [1,1,'true','true',true,true,15,15,false,false, undefined,undefined, null,null, NaN, NaN,'NaN', 0, 0, 'a', 'a',{},{}];
console.log(unique(arr))
//[1, "true", true, 15, false, undefined, null, "NaN", 0, "a", {…}, {…}]这个方法比较巧妙,从头遍历数组,如果元素在前面出现过,则将当前元素挪到最后面,继续遍历,直到遍历完所有元素,之后将那些被挪到后面的元素抛弃。这个方法因为是直接操作数组,占用内存较少。
reduce + includes去重:这个方法就是利用reduce遍历和传入一个空数组作为去重后的新数组,然后内部判断新数组中是否存在当前遍历的元素,不存在就插入到新数组中。这种方法时间消耗多,内存空间也有额外占用。
1
2
3
4
5
6function unique(arr){
return arr.reduce((prev,cur) => prev.includes(cur) ? prev : [...prev,cur],[]);
}
var arr = [1,1,'true','true',true,true,15,15,false,false, undefined,undefined, null,null, NaN, NaN,'NaN', 0, 0, 'a', 'a',{},{}];
console.log(unique(arr));
// [1, "true", true, 15, false, undefined, null, NaN, "NaN", 0, "a", {…}, {…}]
- 方法还有很多,常用的、了解的这些就可以
加分回答: 以上五个方法中,在数据低于10000条的时候没有明显的差别,高于10000条,第一种和第二种的时间消耗最少,后面三种时间消耗依次增加,由于第一种内存空间消耗比较多,且现在很多项目不再考虑低版本浏览器的兼容性问题,所以建议使用第二种去重方法,简洁方便。
(设计题)想实现一个对页面某个节点的拖曳?如何做?(使用原生JS)
- 给需要拖拽的节点绑定
mousedown,mousemove,mouseup事件 mousedown事件触发后,开始拖拽mousemove时,需要通过event.clientX和clientY获取拖拽位置,并实时更新位置mouseup时,拖拽结束- 需要注意浏览器边界的情况
❤ JS 全局函数和全局变量
全局变量
Infinity代表正的无穷大的数值。NaN指示某个值是不是数字值。undefined指示未定义的值。
全局函数
decodeURI()解码某个编码的URI。decodeURIComponent()解码一个编码的URI组件。encodeURI()把字符串编码为 URI。encodeURIComponent()把字符串编码为URI组件。escape()对字符串进行编码。eval()计算JavaScript字符串,并把它作为脚本代码来执行。isFinite()检查某个值是否为有穷大的数。isNaN()检查某个值是否是数字。Number()把对象的值转换为数字。parseFloat()解析一个字符串并返回一个浮点数。parseInt()解析一个字符串并返回一个整数。String()把对象的值转换为字符串。unescape()对由escape()编码的字符串进行解码
❤ 深浅拷贝
参考链接
浅拷贝
Object.assign(target, ...sources)是 ES6 中object的一个方法- 不会拷贝对象的继承属性;
- 不会拷贝对象的不可枚举的属性;
- 可以拷贝
Symbol类型的属性。
1
2
3
4let target = {};
let source = { a: { b: 1 } };
Object.assign(target, source);
console.log(target); // { a: { b: 1 } };依旧存在着访问共同堆内存的问题,也就是说这种方法还不能进一步复制,而只是完成了浅拷贝的功能
扩展运算符方式
- 利用 JS 的扩展运算符,在构造对象的同时完成浅拷贝的功能。
- 扩展运算符的语法为:
let cloneObj = { ...obj };
1
2
3
4
5
6
7
8
9
10
11
12/* 对象的拷贝 */
let obj = {a:1,b:{c:1}}
let obj2 = {...obj}
obj.a = 2
console.log('obj', obj) //{a:2,b:{c:1}}
console.log('obj2', obj2); //{a:1,b:{c:1}}
obj.b.c = 2
console.log('obj', obj) //{a:2,b:{c:2}}
console.log('obj2', obj2); //{a:1,b:{c:2}}
/* 数组的拷贝 */
let arr = [1, 2, 3];
let newArr = [...arr]; //跟arr.slice()是一样的效果扩展运算符 和
object.assign有同样的缺陷,也就是实现的浅拷贝的功能差不多,但是如果属性都是基本类型的值,使用扩展运算符进行浅拷贝会更加方便concat 拷贝数组
数组的
concat方法其实也是浅拷贝,所以连接一个含有引用类型的数组时,需要注意修改原数组中的元素的属性,因为它会影响拷贝之后连接的数组。不过concat只能用于数组的浅拷贝,使用场景比较局限。1
2
3
4
5let arr = [1, 2, 3];
let newArr = arr.concat();
newArr[1] = 100;
console.log(arr); // [ 1, 2, 3 ]
console.log(newArr); // [ 1, 100, 3 ]slice 拷贝数组
slice方法也比较有局限性,因为它仅仅针对数组类型。slice方法会返回一个新的数组对象,这一对象由该方法的前两个参数来决定原数组截取的开始和结束时间,是不会影响和改变原始数组的。slice 的语法为:
arr.slice(begin, end);1
2
3
4
5let arr = [1, 2, {val: 4}];
let newArr = arr.slice();
newArr[2].val = 1000;
console.log(arr); //[ 1, 2, { val: 1000 } ]
console.log(newArr); //[ 1, 2, { val: 1000 } ]
从上面的代码中可以看出,这就是
浅拷贝的限制所在了——它只能拷贝一层对象。如果存在对象的嵌套,那么浅拷贝将无能为力。因此深拷贝就是为了解决这个问题而生的,它能解决多层对象嵌套问题,彻底实现拷贝
手工实现一个浅拷贝
- 暂时不写
深拷贝
浅拷贝只是创建了一个新的对象,复制了原有对象的基本类型的值,而引用数据类型只拷贝了一层属性,再深层的还是无法进行拷贝。深拷贝则不同,对于复杂引用数据类型,其在堆内存中完全开辟了一块内存地址,并将原有的对象完全复制过来存放。这两个对象是相互独立、不受影响的,彻底实现了内存上的分离。总的来说,
深拷贝的原理可以总结如下:将一个对象从内存中完整地拷贝出来一份给目标对象,并从堆内存中开辟一个全新的空间存放新对象,且新对象的修改并不会改变原对象,二者实现真正的分离。
乞丐版(
JSON.stringify)JSON.stringify()是目前开发过程中最简单的深拷贝方法,其实就是把一个对象序列化成为JSON的字符串,并将对象里面的内容转换成字符串,最后再用JSON.parse()的方法将JSON字符串生成一个新的对象1
2
3
4
5
6
7let a = {
age: 1,
jobs: {first: 'FE'}
}
let b = JSON.parse(JSON.stringify(a))
a.jobs.first = 'native'
console.log(b.jobs.first) // FE该方法也是有局限性的
- 会忽略
undefined - 会忽略
symbol - 不能序列化函数
- 无法拷贝不可枚举的属性
- 无法拷贝对象的原型链
- 拷贝
RegExp引用类型会变成空对象 - 拷贝
Date引用类型会变成字符串 - 对象中含有
NaN、Infinity以及-Infinity,JSON序列化的结果会变成null - 不能解决循环引用的对象,即对象成环 (
obj[key] = obj)
使用
JSON.stringify方法实现深拷贝对象,虽然到目前为止还有很多无法实现的功能,但是这种方法足以满足日常的开发需求,并且是最简单和快捷的。而对于其他的也要实现深拷贝的,比较麻烦的属性对应的数据类型,JSON.stringify暂时还是无法满足的,那么就需要下面的几种方法了- 会忽略
基础版(手写递归实现)
下面是一个实现 deepClone 函数封装的例子,通过
for in遍历传入参数的属性值,如果值是引用类型则再次递归调用该函数,如果是基础数据类型就直接复制1
2
3
4
5
6
7
8
9
10
11
12
13
14
15let obj1 = {a:{b:1}}
function deepClone(obj) {
let cloneObj = {}
for(let key in obj) { //遍历
if(typeof obj[key] ==='object') {
cloneObj[key] = deepClone(obj[key]) //是对象就再次调用该函数递归
} else {
cloneObj[key] = obj[key] //基本类型的话直接复制值
}
}
return cloneObj
}
let obj2 = deepClone(obj1);
obj1.a.b = 2;
console.log(obj2); // {a:{b:1}}虽然利用递归能实现一个深拷贝,但是同上面的
JSON.stringify一样,还是有一些问题没有完全解决,例如:- 这个深拷贝函数并不能复制不可枚举的属性以及
Symbol类型; - 这种方法
只是针对普通的引用类型的值做递归复制,而对于Array、Date、RegExp、Error、Function这样的引用类型并不能正确地拷贝; - 对象的属性里面成环,即
循环引用没有解决。
这种基础版本的写法也比较简单,可以应对大部分的应用情况。但是你在面试的过程中,如果只能写出这样的一个有缺陷的深拷贝方法,有可能不会通过。
所以为了“拯救”这些缺陷,下面我带你一起看看改进的版本,以便于你可以在面试种呈现出更好的深拷贝方法,赢得面试官的青睐。
- 这个深拷贝函数并不能复制不可枚举的属性以及
改进版(改进后递归实现)
针对上面几个待解决问题,我先通过四点相关的理论告诉你分别应该怎么做。
- 针对能够遍历对象的不可枚举属性以及
Symbol类型,我们可以使用Reflect.ownKeys方法; - 当参数为
Date、RegExp类型,则直接生成一个新的实例返回; - 利用
Object的getOwnPropertyDescriptors方法可以获得对象的所有属性,以及对应的特性,顺便结合Object.create方法创建一个新对象,并继承传入原对象的原型链; - 利用
WeakMap类型作为Hash表,因为WeakMap是弱引用类型,可以有效防止内存泄漏(你可以关注一下Map和weakMap的关键区别,这里要用weakMap),作为检测循环引用很有帮助,如果存在循环,则引用直接返回WeakMap存储的值
如果你在考虑到循环引用的问题之后,还能用
WeakMap来很好地解决,并且向面试官解释这样做的目的,那么你所展示的代码,以及你对问题思考的全面性,在面试官眼中应该算是合格的了实现深拷贝
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28const isComplexDataType = obj => (typeof obj === 'object' || typeof obj === 'function') && (obj !== null)
const deepClone = function (obj, hash = new WeakMap()) {
if (obj.constructor === Date) {
return new Date(obj) // 日期对象直接返回一个新的日期对象
}
if (obj.constructor === RegExp){
return new RegExp(obj) //正则对象直接返回一个新的正则对象
}
//如果循环引用了就用 weakMap 来解决
if (hash.has(obj)) {
return hash.get(obj)
}
let allDesc = Object.getOwnPropertyDescriptors(obj)
//遍历传入参数所有键的特性
let cloneObj = Object.create(Object.getPrototypeOf(obj), allDesc)
// 把cloneObj原型复制到obj上
hash.set(obj, cloneObj)
for (let key of Reflect.ownKeys(obj)) {
cloneObj[key] = (isComplexDataType(obj[key]) && typeof obj[key] !== 'function') ? deepClone(obj[key], hash) : obj[key]
}
return cloneObj
}- 针对能够遍历对象的不可枚举属性以及
❤ 防抖/节流
防抖
在滚动事件中需要做个复杂计算或者实现一个按钮的防二次点击操作。可以通过函数防抖动来实现
1 | // 函数防抖的实现 最后一次实现 |
对于按钮防点击来说的实现
- 开始一个定时器,只要我定时器还在,不管你怎么点击都不会执行回调函数。一旦定时器结束并设置为 null,就可以再次点击了
- 对于延时执行函数来说的实现:每次调用防抖动函数都会判断本次调用和之前的时间间隔,如果小于需要的时间间隔,就会重新创建一个定时器,并且定时器的延时为设定时间减去之前的时间间隔。一旦时间到了,就会执行相应的回调函数
节流
防抖动和节流本质是不一样的。防抖动是将多次执行变为最后一次执行,节流是将多次执行变成每隔一段时间执行
函数节流(
throttle)是指阻止一个函数在很短时间间隔内连续调用。 只有当上一次函数执行后达到规定的时间间隔,才能进行下一次调用。 但要保证一个累计最小调用间隔(否则拖拽类的节流都将无连续效果)
1 | // 节流:我们这里的节流指的就是在自定义的一段时间内让事件进行触发 |
❤ 事件循环Event loop,宏任务与微任务
首先,
js是单线程的,主要的任务是处理用户的交互,而用户的交互无非就是响应DOM的增删改,使用事件队列的形式,一次事件循环只处理一个事件响应,使得脚本执行相对连续,所以有了事件队列,用来储存待执行的事件,那么事件队列的事件从哪里被push进来的呢。那就是另外一个线程叫事件触发线程做的事情了,他的作用主要是在定时触发器线程、异步HTTP请求线程满足特定条件下的回调函数push到事件队列中,等待js引擎空闲的时候去执行,当然js引擎执行过程中有优先级之分,首先js引擎在一次事件循环中,会先执行js线程的主任务,然后会去查找是否有微任务microtask(promise),如果有那就优先执行微任务,如果没有,在去查找宏任务macrotask(setTimeout、setInterval)进行执行
众所周知
JS是门非阻塞单线程语言,因为在最初JS就是为了和浏览器交互而诞生的。如果JS是门多线程的语言话,我们在多个线程中处理DOM就可能会发生问题(一个线程中新加节点,另一个线程中删除节点)
JS在执行的过程中会产生执行环境,这些执行环境会被顺序的加入到执行栈中。如果遇到异步的代码,会被挂起并加入到Task(有多种task) 队列中。一旦执行栈为空,EventLoop就会从Task队列中拿出需要执行的代码并放入执行栈中执行,所以本质上来说JS中的异步还是同步行为

1 | console.log('script start'); |
不同的任务源会被分配到不同的
Task队列中,任务源可以分为 微任务(microtask) 和 宏任务(macrotask)。在ES6规范中,microtask称为jobs,macrotask称为task
1 | console.log('script start'); |
以上代码虽然
setTimeout写在Promise之前,但是因为Promise属于微任务而setTimeout属于宏任务
微任务
process.nextTickpromiseObject.observeMutationObserver
宏任务
scriptsetTimeoutsetIntervalsetImmediateI/OUI rendering
宏任务中包括了
script,浏览器会先执行一个宏任务,接下来有异步代码的话就先执行微任务
所以正确的一次 Event loop 顺序是这样的
- 执行同步代码,这属于宏任务
- 执行栈为空,查询是否有微任务需要执行
- 执行所有微任务
- 必要的话渲染 UI
- 然后开始下一轮
Event loop,执行宏任务中的异步代码
通过上述的
Event loop顺序可知,如果宏任务中的异步代码有大量的计算并且需要操作DOM的话,为了更快的响应界面响应,我们可以把操作DOM放入微任务中
- 得分点 任务挂起、同步任务执行结束执行队列中的异步任务、执行script标签内部代码、setTimeout/setInterval、ajax请、postMessageMessageChannel、setImmediate、I/O(Node.js)Promise、MutonObserver、Object.observe、process.nextTick(Node.js)每个宏任务中都包含了一个微任务队列
- 标准回答 浏览器的事件循环:执行js代码的时候,遇见同步任务,直接推入调用栈中执行,遇到异步任务,将该任务挂起,等到异步任务有返回之后推入到任务队列中,当调用栈中的所有同步任务全部执行完成,将任务队列中的任务按顺序一个一个的推入并执行,重复执行这一系列的行为。
- 异步任务又分为宏任务和微任务。
- 宏任务:任务队列中的任务称为宏任务,每个宏任务中都包含了一个微任务队列。
- 微任务:等宏任务中的主要功能都完成后,渲染引擎不急着去执行下一个宏任务,而是执行当前宏任务中的微任务
- 宏任务包含:执行script标签内部代码、setTimeout/setInterval、ajax请、postMessageMessageChannel、setImmediate,I/O(Node.js)
- 微任务包含:Promise、MutonObserver、Object.observe、process.nextTick(Node.js)
- 加分回答 浏览器和Node 环境下,microtask 任务队列的执行时机不同
- Node端,microtask 在事件循环的各个阶段之间执行
- 浏览器端,microtask 在事件循环的 macrotask 执行完之后执行
说说事件流
事件流分为两种,捕获事件流和冒泡事件流
- 捕获事件流从根节点开始执行,一直往子节点查找执行,直到查找执行到目标节点
- 冒泡事件流从目标节点开始执行,一直往父节点冒泡查找执行,直到查到到根节点
事件流分为三个阶段,一个是捕获节点,一个是处于目标节点阶段,一个是冒泡阶段
说说从输入URL到看到页面发生的全过程,越详细越好
- 首先浏览器主进程接管,开了一个下载线程。
- 然后进行HTTP请求(DNS查询、IP寻址等等),中间会有三次捂手,等待响应,开始下载响应报文。
- 将下载完的内容转交给Renderer进程管理。
- Renderer进程开始解析css rule tree和dom tree,这两个过程是并行的,所以一般我会把link标签放在页面顶部。
- 解析绘制过程中,当浏览器遇到link标签或者script、img等标签,浏览器会去下载这些内容,遇到时候缓存的使用缓存,不适用缓存的重新下载资源。
- css rule tree和dom tree生成完了之后,开始合成render tree,这个时候浏览器会进行layout,开始计算每一个节点的位置,然后进行绘制。
- 绘制结束后,关闭TCP连接,过程有四次挥手
现在要你完成一个Dialog组件,说说你设计的思路?它应该有什么功能?
- 该组件需要提供
hook指定渲染位置,默认渲染在body下面。 - 然后改组件可以指定外层样式,如宽度等
- 组件外层还需要一层
mask来遮住底层内容,点击mask可以执行传进来的onCancel函数关闭Dialog。 - 另外组件是可控的,需要外层传入
visible表示是否可见。 - 然后
Dialog可能需要自定义头head和底部footer,默认有头部和底部,底部有一个确认按钮和取消按钮,确认按钮会执行外部传进来的onOk事件,然后取消按钮会执行外部传进来的onCancel事件。 - 当组件的
visible为true时候,设置body的overflow为hidden,隐藏body的滚动条,反之显示滚动条。 - 组件高度可能大于页面高度,组件内部需要滚动条。
- 只有组件的
visible有变化且为ture时候,才重渲染组件内的所有内容
caller和callee的区别
callee
caller返回一个函数的引用,这个函数调用了当前的函数。
使用这个属性要注意
- 这个属性只有当函数在执行时才有用
- 如果在
javascript程序中,函数是由顶层调用的,则返回null
functionName.caller: functionName是当前正在执行的函数。
1 | function a() { |
callee
callee放回正在执行的函数本身的引用,它是arguments的一个属性
使用callee时要注意:
- 这个属性只有在函数执行时才有效
- 它有一个
length属性,可以用来获得形参的个数,因此可以用来比较形参和实参个数是否一致,即比较arguments.length是否等于arguments.callee.length - 它可以用来递归匿名函数。
1 | function a() { |
ajax、axios、fetch区别
jQuery ajax
1 | $.ajax({ |
优缺点:
- 本身是针对
MVC的编程,不符合现在前端MVVM的浪潮 - 基于原生的
XHR开发,XHR本身的架构不清晰,已经有了fetch的替代方案 JQuery整个项目太大,单纯使用ajax却要引入整个JQuery非常的不合理(采取个性化打包的方案又不能享受CDN服务)
axios
1 | axios({ |
优缺点:
- 从浏览器中创建
XMLHttpRequest - 从
node.js发出http请求 - 支持
Promise API - 拦截请求和响应
- 转换请求和响应数据
- 取消请求
- 自动转换
JSON数据 - 客户端支持防止
CSRF/XSRF
fetch
1 | try { |
优缺点:
fetcht只对网络请求报错,对400,500都当做成功的请求,需要封装去处理fetch默认不会带cookie,需要添加配置项fetch不支持abort,不支持超时控制,使用setTimeout及Promise.reject的实现的超时控制并不能阻止请求过程继续在后台运行,造成了量的浪费fetch没有办法原生监测请求的进度,而XHR可以
❤ axios 的拦截器原理及应用
- 得分点 请求(request)拦截器、响应(response)拦截器、Promise控制执行顺序、每个请求带上相应的参数、返回的状态进行判断(token是否过期)
- 标准回答
- axios的拦截器的应用场景: 请求拦截器用于在接口请求之前做的处理,比如为每个请求带上相应的参数(token,时间戳等)。 返回拦截器用于在接口返回之后做的处理,比如对返回的状态进行判断(token是否过期)。 axios为开发者提供了这样一个API:拦截器。拦截器分为 请求(request)拦截器和 响应(response)拦截器。
- 拦截器原理:创建一个chn数组,数组中保存了拦截器相应方法以及
dispatchRequest(dispatchRequest这个函数调用才会真正的开始下发请求),把请求拦截器的方法放到chn数组中dispatchRequest的前面,把响应拦截器的方法放到chn数组中dispatchRequest的后面,把请求拦截器和相应拦截器forEach将它们分unshift,push到chn数组中,为了保证它们的执行顺序,需要使用promise,以出队列的方式对chn数组中的方法挨个执行。
- 加分回答
- Axios 是一个基于 promise 的 HTTP 库,可以用在浏览器和 node.js 中。从浏览器中创建
XMLHttpRequests,从 node.js 创建 http 请求,支持 Promise API,可拦截请求和响应,可转换请求数据和响应数据,可取消请求,可自动转换 JSON 数据,客户端支持防御 XSRF
- Axios 是一个基于 promise 的 HTTP 库,可以用在浏览器和 node.js 中。从浏览器中创建
❤ fetch 请求方式
- 得分点 Fetch函数就是原生js、没有使用
XMLHttpRequest对象、头部信息、请求信息、响应信息等均分布到不同的对象 - 标准回答
- fetch是一种HTTP数据请求的方式,是
XMLHttpRequest的一种替代方案。Fetch函数就是原生js,没有使用XMLHttpRequest对象。fetch()方法返回一个Promise解析Response来自Request显示状态(成功与否)的方法。
- fetch是一种HTTP数据请求的方式,是
- 加分回答
- XMLHttpRequest的问题
- 所有的功能全部集中在一个对象上, 容易书写出混乱而且不容易维护的代码 -采用传统的事件驱动模式, 无法适配新的 Promise API Fetch API的特点
- 精细的功能分割: 头部信息, 请求信息, 响应信息等均分布到不同的对象, 更利于处理各种复杂的数据交互场景
- 使用Promise API, 更利于异步代码的书写
- 同源请求也可以自定义不带 cookie,某些服务不需要 cookie 场景下能少些流量
- XMLHttpRequest的问题
❤ JS 继承的方法和优缺点?
构造函数绑定:使用
call或apply方法,将父对象的构造函数绑定在子对象上
1 | function Cat(name,color){ |
- 实例继承:将子对象的 prototype 指向父对象的一个实例
1 | Cat.prototype = new Animal(); |
拷贝继承:如果把父对象的所有属性和方法,拷贝进子对象
1 | function extend(Child, Parent) { |
原型继承:将子对象的
prototype指向父对象的prototype
1 | function extend(Child, Parent) { |
1 | class ColorPoint extends Point { |
牛客网解释:
- 得分点 原型链继承、借用构造函数继承、组合继承、原型式继承、寄生式继承、寄生组合式继承、ES6 Class
- 标准回答
- 原型链继承:让一个构造函数的原型是另一个类型的实例,那么这个构造函数new出来的实例就具有该实例的属性,原型链继承的。优点:写法方便简洁,容易理解。缺点:在父类型构造函数中定义的引用类型值的实例属性,会在子类型原型上变成原型属性被所有子类型实例所共享。同时在创建子类型的实例时,不能向超类型的构造函数中传递参数。
- 借用构造函数继承:在子类型构造函数的内部调用父类型构造函数;使用 apply() 或 call() 方法将父对象的构造函数绑定在子对象上。优点:解决了原型链实现继承的不能传参的问题和父类的原型共享的问题。缺点:借用构造函数的缺点是方法都在构造函数中定义,因此无法实现函数复用。在父类型的原型中定义的方法,对子类型而言也是不可见的,结果所有类型都只能使用构造函数模式。
- 组合继承:将原型链和借用构造函数的组合到一块。使用原型链实现对原型属性和方法的继承,而通过借用构造函数来实现对实例属性的继承。这样,既通过在原型上定义方法实现了函数复用,又能够保证每个实例都有自己的属性。优点就是解决了原型链继承和借用构造函数继承造成的影响。缺点是无论在什么情况下,都会调用两次超类型构造函数:一次是在创建子类型原型的时候,另一次是在子类型构造函数内部
- 原型式继承:在一个函数A内部创建一个临时性的构造函数,然后将传入的对象作为这个构造函数的原型,最后返回这个临时类型的一个新实例。本质上,函数A是对传入的对象执行了一次浅复制。ECMAScript 5通过增加Object.create()方法将原型式继承的概念规范化了。这个方法接收两个参数:作为新对象原型的对象,以及给新对象定义额外属性的对象(第二个可选)。在只有一个参数时,Object.create()与这里的函数A方法效果相同。优点是:不需要单独创建构造函数。缺点是:属性中包含的引用值始终会在相关对象间共享
- 寄生式继承:寄生式继承背后的思路类似于寄生构造函数和工厂模式:创建一个实现继承的函数,以某种方式增强对象,然后返回这个对象。优点:写法简单,不需要单独创建构造函数。缺点:通过寄生式继承给对象添加函数会导致函数难以重用。
- 寄生组合式继承:通过借用构造函数来继承属性,通过原型链的混成形式来继承方法。本质上,就是使用寄生式继承来继承超类型的原型,然后再将结果指定给子类型的原型。优点是:高效率只调用一次父构造函数,并且因此避免了在子原型上面创建不必要,多余的属性。与此同时,原型链还能保持不变;缺点是:代码复杂
- 加分回答
- ES6 Class实现继承。
- 原理:原理ES5 的继承,实质是先创造子类的实例对象this,然后再将父类的方法添加到this上面(Parent.apply(this))。 ES6 的继承机制完全不同,实质是先将父类实例对象的属性和方法,加到this上面(所以必须先调用super方法),然后再用子类的构造函数修改this。需要注意的是,class关键字只是原型的语法糖,JavaScript继承仍然是基于原型实现的。 优点:语法简单易懂,操作更方便。缺点:并不是所有的浏览器都支持class关键字
1 | class Person { |
数组相关:
❤ JS 数组常用方法
join()通过指定连接符生成字符串push()和pop()末尾推入和弹出,改变原数组, 返回推入/弹出项shift()和unshift()头部推入和弹出,改变原数组,返回操作项sort()排序,改变原数组reverse()反转,改变原数组concat()连接数组,不影响原数组, 浅拷贝slice(start, end)返回截断后的新数组,不改变原数组splice(start, number, value...)返回删除元素组成的数组,value为插入项,改变原数组indexOf(value, fromIndex)和lastIndexOf(value, fromIndex)查找数组项,返回对应的下标forEach()无法break,可以用try/catch中throw new Error来停止filter()过滤every()有一项返回false,则整体为falsesome()有一项返回true,则整体为truetoString()map()遍历数组,返回回调返回值组成的新数组reduce() / reduceRight(fn(prev, cur),defaultPrev): 两两执行,prev为上次化简函数的return值,cur为当前值(从第二项开始)
join()把数组转换成字符串,然后给他规定个连接字符,默认的是逗号( ,)
书写格式:join(“ “),括号里面写字符串 (“要加引号”),
1
2
3
4var arr = [1,2,3];
console.log(arr.join()); // 1,2,3
console.log(arr.join("-")); // 1-2-3
console.log(arr); // [1, 2, 3](原数组不变)push()和pop()push(): 把里面的内容添加到数组末尾,并返回修改后的长度。pop():移除数组最后一项,返回移除的那个值,减少数组的length。 书写格式:
arr.push(" "),括号里面写内容 (“字符串要加引号”), 书写格式:
arr.pop( )1
2
3
4
5
6
7var arr = ["Lily","lucy","Tom"];
var count = arr.push("Jack","Sean");
console.log(count); // 5
console.log(arr); // ["Lily", "lucy", "Tom", "Jack", "Sean"]
var item = arr.pop();
console.log(item); // Sean
console.log(arr); // ["Lily", "lucy", "Tom", "Jack"]shift()和unshift()shift():删除原数组第一项,并返回删除元素的值;如果数组为空则返回undefined。unshift():将参数添加到原数组开头,并返回数组的长度 。书写格式:
arr.shift(" "),括号里面写内容 (“字符串要加引号”)1
2
3
4
5
6
7var arr = ["Lily","lucy","Tom"];
var count = arr.unshift("Jack","Sean");
console.log(count); // 5
console.log(arr); //["Jack", "Sean", "Lily", "lucy", "Tom"]
var item = arr.shift();
console.log(item); // Jack
console.log(arr); // ["Sean", "Lily", "lucy", "Tom"]sort()sort():将数组里的项从小到大排序1
2var arr1 = ["a", "d", "c", "b"];
console.log(arr1.sort()); // ["a", "b", "c", "d"reverse()reverse():反转数组项的顺序。1
2
3var arr = [13, 24, 51, 3];
console.log(arr.reverse()); //[3, 51, 24, 13]
console.log(arr); //[3, 51, 24, 13](原数组改变)concat()concat():将参数添加到原数组中。这个方法会先创建当前数组一个副本,然后将接收到的参数添加到这个副本的末尾,最后返回新构建的数组。在没有给 concat()方法传递参数的情况下,它只是复制当前数组并返回副本。书写格式:arr.concat(),括号里面写内容 (“字符串要加引号”)
1
2
3
4var arr = [1,3,5,7];
var arrCopy = arr.concat(9,[11,13]);
console.log(arrCopy); //[1, 3, 5, 7, 9, 11, 13]
console.log(arr); // [1, 3, 5, 7](原数组未被修改)slice()slice():返回从原数组中指定开始下标到结束下标之间的项组成的新数组。slice()方法可以接受一或两个参数,即要返回项的起始和结束位置。在只有一个参数的情况下, slice()方法返回从该参数指定位置开始到当前数组末尾的所有项。如果有两个参数,该方法返回起始和结束位置之间的项——但不包括结束位置的项。书写格式:arr.slice( 1 , 3 )
1
2
3
4
5
6
7
8
9
10var arr = [1,3,5,7,9,11];
var arrCopy = arr.slice(1);
var arrCopy2 = arr.slice(1,4);
var arrCopy3 = arr.slice(1,-2);
var arrCopy4 = arr.slice(-4,-1);
console.log(arr); //[1, 3, 5, 7, 9, 11](原数组没变)
console.log(arrCopy); //[3, 5, 7, 9, 11]
console.log(arrCopy2); //[3, 5, 7]
console.log(arrCopy3); //[3, 5, 7]
console.log(arrCopy4); //[5, 7, 9]splice()splice():删除、插入和替换。
删除:指定 2 个参数:要删除的第一项的位置和要删除的项数。
书写格式:arr.splice( 1 , 3 )
插入:可以向指定位置插入任意数量的项,只需提供 3 个参数:起始位置、 0(要删除的项数)和要插入的项。
书写格式:arr.splice( 2,0,4,6 )
替换:可以向指定位置插入任意数量的项,且同时删除任意数量的项,只需指定 3 个参数:起始位置、要删除的项数和要插入的任意数量的项。插入的项数不必与删除的项数相等。书写格式:arr.splice( 2,0,4,6 )
1
2
3
4
5
6
7
8
9
10var arr = [1,3,5,7,9,11];
var arrRemoved = arr.splice(0,2);
console.log(arr); //[5, 7, 9, 11]
console.log(arrRemoved); //[1, 3]
var arrRemoved2 = arr.splice(2,0,4,6);
console.log(arr); // [5, 7, 4, 6, 9, 11]
console.log(arrRemoved2); // []
var arrRemoved3 = arr.splice(1,1,2,4);
console.log(arr); // [5, 2, 4, 4, 6, 9, 11]
console.log(arrRemoved3); //[7]indexOf()VSlastIndexOf()indexOf():接收两个参数:要查找的项和(可选的)表示查找起点位置的索引。其中, 从数组的开头(位置 0)开始向后查找。书写格式:arr.indexof( 5 )
lastIndexOf:接收两个参数:要查找的项和(可选的)表示查找起点位置的索引。其中, 从数组的末尾开始向前查找。书写格式:arr.lastIndexOf( 5,4 )
1
2
3
4
5
6var arr = [1,3,5,7,7,5,3,1];
console.log(arr.indexOf(5)); // 2
console.log(arr.lastIndexOf(5)); // 5
console.log(arr.indexOf(5,2)); // 2
console.log(arr.lastIndexOf(5,4)); // 2
console.log(arr.indexOf("5")); // -1forEach()forEach():对数组进行遍历循环,对数组中的每一项运行给定函数。这个方法没有返回值。参数都是function类型,默认有传参,参数分别为:遍历的数组内容;第对应的数组索引,数组本身。书写格式:arr.forEach()
1
2
3
4
5
6
7
8
9
10var arr = [1, 2, 3, 4, 5];
arr.forEach(function(x, index, a){
console.log(x + '|' + index + '|' + (a === arr));
});
// 输出为:
// 1|0|true
// 2|1|true
// 3|2|true
// 4|3|true
// 5|4|truefilter()filter():“过滤”功能,数组中的每一项运行给定函数,返回满足过滤条件组成的数组。
书写格式:arr.filter()
1
2
3
4
5var arr = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10];
var arr2 = arr.filter(function(x, index) {
return index % 3 === 0 || x >= 8;
});
console.log(arr2); //[1, 4, 7, 8, 9, 10]every()every():判断数组中每一项都是否满足条件,只有所有项都满足条件,才会返回true。
书写格式:arr.every()
1
2
3
4
5
6
7
8
9var arr = [1, 2, 3, 4, 5];
var arr2 = arr.every(function(x) {
return x < 10;
});
console.log(arr2); //true
var arr3 = arr.every(function(x) {
return x < 3;
});
console.log(arr3); // falsesome()some():判断数组中是否存在满足条件的项,只要有一项满足条件,就会返回true。
书写格式:arr.some()
1
2
3
4
5
6
7
8
9var arr = [1, 2, 3, 4, 5];
var arr2 = arr.some(function(x) {
return x < 3;
});
console.log(arr2); //true
var arr3 = arr.some(function(x) {
return x < 1;
});
console.log(arr3); // falsetoString()toString():将数组转换成字符串,并用“,”连接,类似于array.join(“,”);
书写格式:arr.toString()
1
2var arr = [1,2,3,4,5];
arr.toString() // "1,2,3,4,5"map()map():将数组映射为想要的数组并返回新数组;map回调方法有两个参数,第一个参数:数组的每一项;
第二个参数为索引;
书写格式:
arr.map((item, index) => ......)或者arr.map(function (item, index){......})1
2
3
4
5
6var arr = ['a', 'b', 'c', 'd', 'e'];
var arr1 = arr.map(function (item, index) {
return item + index
});
arr1; //['a0', 'b1', 'c2', 'd3', 'c4'];
// 以上方法可以改写为: var arr1 = arr.map((item, index) => item + index);reduce()
数组乱序:
1 | var arr = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]; |
数组拆解: flat: [1,[2,3]] –> [1, 2, 3]
1 | Array.prototype.flat = function() { |
Array(3) 和 Array(3, 4)的区别
1 | console.log(Array(3)) // [empty x 3] |
请创建一个长度为100,值都为1的数组
1 | new Array(100).fill(1) |
请创建一个长度为100,值为对应下标的数组
1 | // cool的写法: |
列举 JS 数组和对象有哪些原生方法?
数组:
arr.concat(arr1, arr2, arrn);arr.join(",");arr.sort(func);arr.pop();arr.push(e1, e2, en);arr.shift();arr.unshift(e1, e2, en);arr.reverse();arr.slice(start, end);arr.splice(index, count, e1, e2, en);arr.indexOf(el);arr.includes(el);// ES6
对象:
object.hasOwnProperty(prop);object.propertyIsEnumerable(prop);object.valueOf();object.toString();object.toLocaleString();Class.prototype.isPropertyOf(object);
❤ 判断数组的方法
instanceof方法instanceof运算符是用来测试一个对象是否在其原型链原型构造函数的属性
1 | var arr = []; |
constructor方法constructor属性返回对创建此对象的数组函数的引用,就是返回对象相对应的构造函数
1 | var arr = []; |
- 最简单的方法
1 | Object.prototype.toString.call(value) == '[object Array]' |
ES6新增方法isArray()
1 | var a = new Array(123); |
- 原型链方法
1 | var arr = []; |
slice() 与 splice() 的区别
slice
“读取”数组指定的元素,不会对原数组进行修改
- 语法:
arr.slice(start, end) start指定选取开始位置(含)end指定选取结束位置(不含)
splice
“操作”数组指定的元素,会修改原数组,返回被删除的元素 可以 删除 新增 替换
- 语法:
arr.splice(index, count, [insert Elements]) index是操作的起始位置count = 0插入元素,count > 0删除元素[insert Elements]向数组新插入的元素
删除指定 index 的数组元素
splice 删除
1
2
3
4
5
6
7var delete_index = 2
var arr = [1,2,3,4,5]
// arr => [1,2,3,4,5]
var new_arr = arr.splice(delete_index, 1)
// new_arr => [3]
// arr => [1,2,4,5]
arr.splice(arr.indexOf(2), 1) // 这种好用for 删除
1
2
3
4
5
6
7
8
9
10
11
12var delete_index = 2,
arr = [1,2,3,4,5],
new_arr = []
for (let i = 0, len = arr.length; i < len; i++) {
if (i != delete_index) {
new_arr.push(arr[i])
}
}
// arr => [1,2,3,4,5]
// new_arr => [1,2,4,5]
注意:
不可以使用 delete 方式删除数组中某个元素,此操作会造成稀疏数组,被删除的元素的为位置依然存在为empty,且数组的长度不变
不可以使用 forEach 方法比对数组下标值,因为 forEach 在循环的时候是无序的
判断数组中是否包含某个值
方法一:array.indexOf()
此方法判断数组中是否存在某个值,如果存在,则返回数组元素的下标,否则返回
-1。
1 | var arr=[1,2,3,4]; |
方法二:array.includes(searcElement[,fromIndex])
此方法判断数组中是否存在某个值,如果存在返回
true,否则返回false
1 | var arr=[1,2,3,4]; |
方法三:array.find(callback[,thisArg])
返回数组中满足条件的第一个元素的值,如果没有,返回
undefined
1 | var arr=[1,2,3,4]; |
方法四:array.findeIndex(callback[,thisArg])
返回数组中满足条件的第一个元素的下标,如果没有找到,返回
-1
1 | var arr=[1,2,3,4]; |
JS 中 flat—数组扁平化
对于前端项目开发过程中,偶尔会出现层叠数据结构的数组,我们需要将多层级数组转化为一级数组(即提取嵌套数组元素最终合并为一个数组),使其内容合并且展开。那么该如何去实现呢?
需求:多维数组=>一维数组
1 | let ary = [1, [2, [3, [4, 5]]], 6];// -> [1, 2, 3, 4, 5, 6] |
1. 调用ES6中的flat方法
1 | ary = ary.flat(Infinity); |
2. replace + split
1 | ary = str.replace(/(\[|\])/g, '').split(',') |
3. replace + JSON.parse
1 | str = str.replace(/(\[|\])/g, ''); |
4. 普通递归
1 | let result = []; |
5. 利用reduce函数迭代
1 | function flatten(ary) { |
6. 扩展运算符
1 | //只要有一个元素有数组,那么循环继续 |
MVVM
MVVM 由以下三个内容组成
View:界面Model:数据模型ViewModel:作为桥梁负责沟通View和Model
- 在 JQuery 时期,如果需要刷新 UI 时,需要先取到对应的 DOM 再更新 UI,这样数据和业务的逻辑就和页面有强耦合
- 在 MVVM 中,UI 是通过数据驱动的,数据一旦改变就会相应的刷新对应的 UI,UI 如果改变,也会改变对应的数据。这种方式就可以在业务处理中只关心数据的流转,而无需直接和页面打交道。ViewModel 只关心数据和业务的处理,不关心 View 如何处理数据,在这种情况下,View 和 Model 都可以独立出来,任何一方改变了也不一定需要改变另一方,并且可以将一些可复用的逻辑放在一个 ViewModel 中,让多个 View 复用这个 ViewModel
- 在 MVVM 中,最核心的也就是数据双向绑定,例如 Angluar 的脏数据检测,Vue 中的数据劫持
脏数据检测
- 当触发了指定事件后会进入脏数据检测,这时会调用 $digest 循环遍历所有的数据观察者,判断当前值是否和先前的值有区别,如果检测到变化的话,会调用 $watch 函数,然后再次调用 $digest 循环直到发现没有变化。循环至少为二次 ,至多为十次
- 脏数据检测虽然存在低效的问题,但是不关心数据是通过什么方式改变的,都可以完成任务,但是这在 Vue 中的双向绑定是存在问题的。并且脏数据检测可以实现批量检测出更新的值,再去统一更新 UI,大大减少了操作 DOM 的次数
数据劫持
Vue内部使用了Obeject.defineProperty()来实现双向绑定,通过这个函数可以监听到set和get的事件
1 | var data = { name: 'yck' } |
以上代码简单的实现了如何监听数据的 set 和 get 的事件,但是仅仅如此是不够的,还需要在适当的时候给属性添加发布订阅
1 | <div> |
在解析如上模板代码时,遇到
{name}就会给属性name添加发布订阅
1 | // 通过 Dep 解耦 |
接下来,对 defineReactive 函数进行改造
1 | function defineReactive(obj, key, val) { |
以上实现了一个简易的双向绑定,核心思路就是手动触发一次属性的 getter 来实现发布订阅的添加
Proxy 与 Obeject.defineProperty 对比
Obeject.defineProperty虽然已经能够实现双向绑定了,但是他还是有缺陷的。- 只能对属性进行数据劫持,所以需要深度遍历整个对象
- 对于数组不能监听到数据的变化
虽然
Vue中确实能检测到数组数据的变化,但是其实是使用了hack的办法,并且也是有缺陷的
继承
- 原型链继承,将父类的实例作为子类的原型,他的特点是实例是子类的实例也是父类的实例,父类新增的原型方法/属性,子类都能够访问,并且原型链继承简单易于实现,缺点是来自原型对象的所有属性被所有实例共享,无法实现多继承,无法向父类构造函数传参。
- 构造继承,使用父类的构造函数来增强子类实例,即复制父类的实例属性给子类,构造继承可以向父类传递参数,可以实现多继承,通过
call多个父类对象。但是构造继承只能继承父类的实例属性和方法,不能继承原型属性和方法,无法实现函数服用,每个子类都有父类实例函数的副本,影响性能 - 实例继承,为父类实例添加新特性,作为子类实例返回,实例继承的特点是不限制调用方法,不管是new 子类()还是子类()返回的对象具有相同的效果,缺点是实例是父类的实例,不是子类的实例,不支持多继承
- 拷贝继承:特点:支持多继承,缺点:效率较低,内存占用高(因为要拷贝父类的属性)无法获取父类不可枚举的方法(不可枚举方法,不能使用
for in访问到) - 组合继承:通过调用父类构造,继承父类的属性并保留传参的优点,然后通过将父类实例作为子类原型,实现函数复用
- 寄生组合继承:通过寄生方式,砍掉父类的实例属性,这样,在调用两次父类的构造的时候,就不会初始化两次实例方法/属性,避免的组合继承的缺点
加载
1. 异步加载js的方法
defer:只支持IE如果您的脚本不会改变文档的内容,可将defer属性加入到<script>标签中,以便加快处理文档的速度。因为浏览器知道它将能够安全地读取文档的剩余部分而不用执行脚本,它将推迟对脚本的解释,直到文档已经显示给用户为止async:HTML5属性,仅适用于外部脚本;并且如果在IE中,同时存在defer和async,那么defer的优先级比较高;脚本将在页面完成时执行
2. 图片的懒加载和预加载
- 预加载:提前加载图片,当用户需要查看时可直接从本地缓存中渲染。
- 懒加载:懒加载的主要目的是作为服务器前端的优化,减少请求数或延迟请求数
两种技术的本质:两者的行为是相反的,一个是提前加载,一个是迟缓甚至不加载。懒加载对服务器前端有一定的缓解压力作用,预加载则会增加服务器前端压力。
有四个操作会忽略enumerable为false的属性
for...in循环:只遍历对象自身的和继承的可枚举的属性。Object.keys():返回对象自身的所有可枚举的属性的键名。JSON.stringify():只串行化对象自身的可枚举的属性。Object.assign(): 忽略enumerable为false的属性,只拷贝对象自身的可枚举的属性。
属性的遍历
ES6 一共有 5 种方法可以遍历对象的属性。
(1)for…in
for...in循环遍历对象自身的和继承的可枚举属性(不含 Symbol 属性)。
(2)Object.keys(obj)
Object.keys返回一个数组,包括对象自身的(不含继承的)所有可枚举属性(不含 Symbol 属性)的键名。
(3)Object.getOwnPropertyNames(obj)
Object.getOwnPropertyNames返回一个数组,包含对象自身的所有属性(不含 Symbol 属性,但是包括不可枚举属性)的键名。
(4)Object.getOwnPropertySymbols(obj)
Object.getOwnPropertySymbols返回一个数组,包含对象自身的所有 Symbol 属性的键名。
(5)Reflect.ownKeys(obj)
Reflect.ownKeys返回一个数组,包含对象自身的(不含继承的)所有键名,不管键名是 Symbol 或字符串,也不管是否可枚举。
以上的 5 种方法遍历对象的键名,都遵守同样的属性遍历的次序规则。
- 首先遍历所有数值键,按照数值升序排列。
- 其次遍历所有字符串键,按照加入时间升序排列。
- 最后遍历所有 Symbol 键,按照加入时间升序排列。
1 | Reflect.ownKeys({ [Symbol()]:0, b:0, 10:0, 2:0, a:0 }) |
上面代码中,
Reflect.ownKeys方法返回一个数组,包含了参数对象的所有属性。这个数组的属性次序是这样的,首先是数值属性2和10,其次是字符串属性b和a,最后是Symbol属性。
为什么通常在发送数据埋点请求的时候使用的是 1x1 像素的透明 gif 图片
- 能够完成整个 HTTP 请求+响应(尽管不需要响应内容)
- 触发 GET 请求之后不需要获取和处理数据、服务器也不需要发送数据
- 跨域友好
- 执行过程无阻塞
- 相比 XMLHttpRequest 对象发送 GET 请求,性能上更好
- GIF的最低合法体积最小(最小的BMP文件需要74个字节,PNG需要67个字节,而合法的GIF,只需要43个字节)
对原生Javascript了解程度
- 数据类型、运算、对象、Function、继承、闭包、作用域、原型链、事件、
RegExp、JSON、Ajax、DOM、BOM、内存泄漏、跨域、异步装载、模板引擎、前端MVC、路由、模块化、Canvas、ECMAScript
Js动画与CSS动画区别及相应实现
CSS3的动画的优点- 在性能上会稍微好一些,浏览器会对
CSS3的动画做一些优化 - 代码相对简单
- 在性能上会稍微好一些,浏览器会对
- 缺点
- 在动画控制上不够灵活
- 兼容性不好
JavaScript的动画正好弥补了这两个缺点,控制能力很强,可以单帧的控制、变换,同时写得好完全可以兼容IE6,并且功能强大。对于一些复杂控制的动画,使用javascript会比较靠谱。而在实现一些小的交互动效的时候,就多考虑考虑CSS吧
JS 数组和对象的遍历方式,以及几种方式的比较
通常我们会用循环的方式来遍历数组。但是循环是 导致js 性能问题的原因之一。一般我们会采用下几种方式来进行数组的遍历
for in循环for循环forEach- 这里的
forEach回调中两个参数分别为value,index forEach无法遍历对象- IE不支持该方法;
Firefox和chrome支持 forEach无法使用break,continue跳出循环,且使用return是跳过本次循环
- 这里的
- 这两种方法应该非常常见且使用很频繁。但实际上,这两种方法都存在性能问题
- 在方式一中,
for-in需要分析出array的每个属性,这个操作性能开销很大。用在key已知的数组上是非常不划算的。所以尽量不要用for-in,除非你不清楚要处理哪些属性,例如JSON对象这样的情况 - 在方式2中,循环每进行一次,就要检查一下数组长度。读取属性(数组长度)要比读局部变量慢,尤其是当
array里存放的都是DOM元素,因为每次读取都会扫描一遍页面上的选择器相关元素,速度会大大降低
事件的各个阶段
- 1:捕获阶段 —> 2:目标阶段 —> 3:冒泡阶段
document—>target目标 —->document- 由此,
addEventListener的第三个参数设置为true和false的区别已经非常清晰了true表示该元素在事件的“捕获阶段”(由外往内传递时)响应事件false表示该元素在事件的“冒泡阶段”(由内向外传递时)响应事件
如何渲染几万条数据并不卡住界面
这道题考察了如何在不卡住页面的情况下渲染数据,也就是说不能一次性将几万条都渲染出来,而应该一次渲染部分
DOM,那么就可以通过requestAnimationFrame来每16 ms刷新一次
1 |
|
希望获取到页面中所有的checkbox怎么做?
不使用第三方框架
1 | var domList = document.getElementsByTagName(‘input’) |
JS 添加、移除、移动、复制、创建和查找节点
创建新节点
1 | createDocumentFragment() //创建一个DOM片段 |
添加、移除、替换、插入
1 | appendChild() //添加 |
查找
1 | getElementsByTagName() //通过标签名称 |
正则表达式
正则表达式构造函数
var reg=new RegExp(“xxx”)与正则表达字面量var reg=//有什么不同?匹配邮箱的正则表达式?
- 当使用
RegExp()构造函数的时候,不仅需要转义引号(即\”表示”),并且还需要双反斜杠(即\\表示一个\)。使用正则表达字面量的效率更高
邮箱的正则匹配:
1 | var regMail = /^([a-zA-Z0-9_-])+@([a-zA-Z0-9_-])+((.[a-zA-Z0-9_-]{2,3}){1,2})$/; |
JS 中 callee 和 caller 的作用?
caller是返回一个对函数的引用,该函数调用了当前函数;callee是返回正在被执行的function函数,也就是所指定的function对象的正文
那么问题来了?如果一对兔子每月生一对兔子;一对新生兔,从第二个月起就开始生兔子;假定每对兔子都是一雌一雄,试问一对兔子,第n个月能繁殖成多少对兔子?(使用
callee完成)
1 | var result=[]; |
window.onload和$(document).ready
原生
JS的window.onload与Jquery的$(document).ready(function(){})有什么不同?如何用原生JS实现Jq的ready方法?
window.onload()方法是必须等到页面内包括图片的所有元素加载完毕后才能执行。$(document).ready()是DOM结构绘制完毕后就执行,不必等到加载完毕
1 | function ready(fn){ |
addEventListener()和attachEvent()的区别
addEventListener()是符合W3C规范的标准方法;attachEvent()是IE低版本的非标准方法addEventListener()支持事件冒泡和事件捕获; - 而attachEvent()只支持事件冒泡addEventListener()的第一个参数中,事件类型不需要添加on;attachEvent()需要添加'on'- 如果为同一个元素绑定多个事件,
addEventListener()会按照事件绑定的顺序依次执行,attachEvent()会按照事件绑定的顺序倒序执行
获取页面所有的checkbox
1 | var resultArr= []; |
JavaScript 对象生命周期的理解
- 当创建一个对象时,
JavaScript会自动为该对象分配适当的内存 - 垃圾回收器定期扫描对象,并计算引用了该对象的其他对象的数量
- 如果被引用数量为
0,或惟一引用是循环的,那么该对象的内存即可回收
我现在有一个canvas,上面随机布着一些黑块,请实现方法,计算canvas上有多少个黑块
https://www.jianshu.com/p/f54d265f7aa4
介绍 DOM 的发展
DOM:文档对象模型(Document Object Model),定义了访问HTML和XML文档的标准,与编程语言及平台无关DOM0:提供了查询和操作Web文档的内容API。未形成标准,实现混乱。如:document.forms['login']DOM1:W3C提出标准化的DOM,简化了对文档中任意部分的访问和操作。如:JavaScript中的Document对象DOM2:原来DOM基础上扩充了鼠标事件等细分模块,增加了对CSS的支持。如:getComputedStyle(elem, pseudo)DOM3:增加了XPath模块和加载与保存(Load and Save)模块。如:XPathEvaluator
介绍DOM0,DOM2,DOM3事件处理方式区别
- DOM0级事件处理方式:
btn.onclick = func;btn.onclick = null;
- DOM2级事件处理方式:
btn.addEventListener('click', func, false);btn.removeEventListener('click', func, false);btn.attachEvent("onclick", func);btn.detachEvent("onclick", func);
- DOM3级事件处理方式:
eventUtil.addListener(input, "textInput", func);eventUtil是自定义对象,textInput是DOM3级事件
事件的三个阶段
- 捕获、目标、冒泡
介绍事件“捕获”和“冒泡”执行顺序和事件的执行次数
- 按照W3C标准的事件:首是进入捕获阶段,直到达到目标元素,再进入冒泡阶段
- 事件执行次数(DOM2-addEventListener):元素上绑定事件的个数
- 注意1:前提是事件被确实触发
- 注意2:事件绑定几次就算几个事件,即使类型和功能完全一样也不会“覆盖”
- 事件执行顺序:判断的关键是否目标元素
- 非目标元素:根据W3C的标准执行:捕获->目标元素->冒泡(不依据事件绑定顺序)
- 目标元素:依据事件绑定顺序:先绑定的事件先执行(不依据捕获冒泡标准)
- 最终顺序:父元素捕获->目标元素事件1->目标元素事件2->子元素捕获->子元素冒泡->父元素冒泡
- 注意:子元素事件执行前提 事件确实“落”到子元素布局区域上,而不是简单的具有嵌套关系
在一个DOM上同时绑定两个点击事件:一个用捕获,一个用冒泡。事件会执行几次,先执行冒泡还是捕获?
- 该DOM上的事件如果被触发,会执行两次(执行次数等于绑定次数)
- 如果该DOM是目标元素,则按事件绑定顺序执行,不区分冒泡/捕获
- 如果该DOM是处于事件流中的非目标元素,则先执行捕获,后执行冒泡
事件的代理/委托
- 事件委托是指将事件绑定目标元素的到父元素上,利用冒泡机制触发该事件
- 优点:
- 可以减少事件注册,节省大量内存占用
- 可以将事件应用于动态添加的子元素上
- 缺点: 使用不当会造成事件在不应该触发时触发
- 示例:
- 优点:
1 | ulEl.addEventListener('click', function(e){ |
W3C事件的 target 与 currentTarget 的区别?
target只会出现在事件流的目标阶段currentTarget可能出现在事件流的任何阶段- 当事件流处在目标阶段时,二者的指向相同
- 当事件流处于捕获或冒泡阶段时:
currentTarget指向当前事件活动的对象(一般为父级)
如何派发事件(dispatchEvent)?(如何进行事件广播?)
- W3C: 使用
dispatchEvent方法 - IE: 使用
fireEvent方法
1 | var fireEvent = function(element, event){ |
区分“客户区坐标”、“页面坐标”、“屏幕坐标”
- 客户区坐标:鼠标指针在可视区中的水平坐标(
clientX)和垂直坐标(clientY) - 页面坐标:鼠标指针在页面布局中的水平坐标(
pageX)和垂直坐标(pageY) - 屏幕坐标:设备物理屏幕的水平坐标(
screenX)和垂直坐标(screenY)
如何获得一个DOM元素的绝对位置?
elem.offsetLeft:返回元素相对于其定位父级左侧的距离elem.offsetTop:返回元素相对于其定位父级顶部的距离elem.getBoundingClientRect():返回一个DOMRect对象,包含一组描述边框的只读属性,单位像素
解释一下这段代码的意思
1 | [].forEach.call($$("*"), function(el){ |
- 解释:获取页面所有的元素,遍历这些元素,为它们添加1像素随机颜色的轮廓(outline)
$$(sel)// $$函数被许多现代浏览器命令行支持,等价于 document.querySelectorAll(sel)
[].forEach.call(NodeLists)// 使用 call 函数将数组遍历函数 forEach 应到节点元素列表
el.style.outline = "1px solid #333"// 样式 outline 位于盒模型之外,不影响元素布局位置
(1<<24)// parseInt(“ffffff”, 16) == 16777215 == 2^24 - 1 // 1<<24 == 2^24 == 16777216
Math.random()*(1<<24)// 表示一个位于 0 到 16777216 之间的随机浮点数
~~Math.random()*(1<<24)//~~作用相当于 parseInt 取整
(~~(Math.random()*(1<<24))).toString(16)// 转换为一个十六进制
请解释一下 JS 的同源策略
- 概念:同源策略是客户端脚本(尤其是Javascript)的重要的安全度量标准。它最早出自Netscape Navigator2.0,其目的是防止某个文档或脚本从多个不同源装载。这里的同源策略指的是:协议,域名,端口相同,同源策略是一种安全协议
- 指一段脚本只能读取来自同一来源的窗口和文档的属性
为什么要有同源限制?
- 我们举例说明:比如一个黑客程序,他利用Iframe把真正的银行登录页面嵌到他的页面上,当你使用真实的用户名,密码登录时,他的页面就可以通过Javascript读取到你的表单中input中的内容,这样用户名,密码就轻松到手了。
- 缺点
- 现在网站的JS都会进行压缩,一些文件用了严格模式,而另一些没有。这时这些本来是严格模式的文件,被 merge后,这个串就到了文件的中间,不仅没有指示严格模式,反而在压缩后浪费了字节
如何删除一个cookie
- 将时间设为当前时间往前一点
1 | var date = new Date(); |
setDate()方法用于设置一个月的某一天
expires的设置
1 | document.cookie = 'user='+ encodeURIComponent('name') + ';expires = ' + new Date(0) |
页面编码和被请求的资源编码如果不一致如何处理
- 后端响应头设置
charset - 前端页面
<meta>设置charset
把<script>放在</body>之前和之后有什么区别?浏览器会如何解析它们?
- 按照HTML标准,在
</body>结束后出现<script>或任何元素的开始标签,都是解析错误 - 虽然不符合HTML标准,但浏览器会自动容错,使实际效果与写在
</body>之前没有区别 - 浏览器的容错机制会忽略
<script>之前的</body>,视作<script>仍在 body 体内。省略</body>和</html>闭合标签符合HTML标准,服务器可以利用这一标准尽可能少输出内容
JS 中,调用函数有哪几种方式
- 方法调用模式
Foo.foo(arg1, arg2); - 函数调用模式
foo(arg1, arg2); - 构造器调用模式
(new Foo())(arg1, arg2); call/applay调用模式Foo.foo.call(that, arg1, arg2);bind调用模式Foo.foo.bind(that)(arg1, arg2)();
简单实现 Function.bind 函数
1 | if (!Function.prototype.bind) { |
什么是单线程,和异步的关系
- 单线程 - 只有一个线程,只能做一件事
- 原因 - 避免
DOM渲染的冲突- 浏览器需要渲染
DOM JS可以修改DOM结构JS执行的时候,浏览器DOM渲染会暂停- 两段 JS 也不能同时执行(都修改
DOM就冲突了) webworker支持多线程,但是不能访问DOM
- 浏览器需要渲染
- 解决方案 - 异步
是否用过 jQuery 的 Deferred
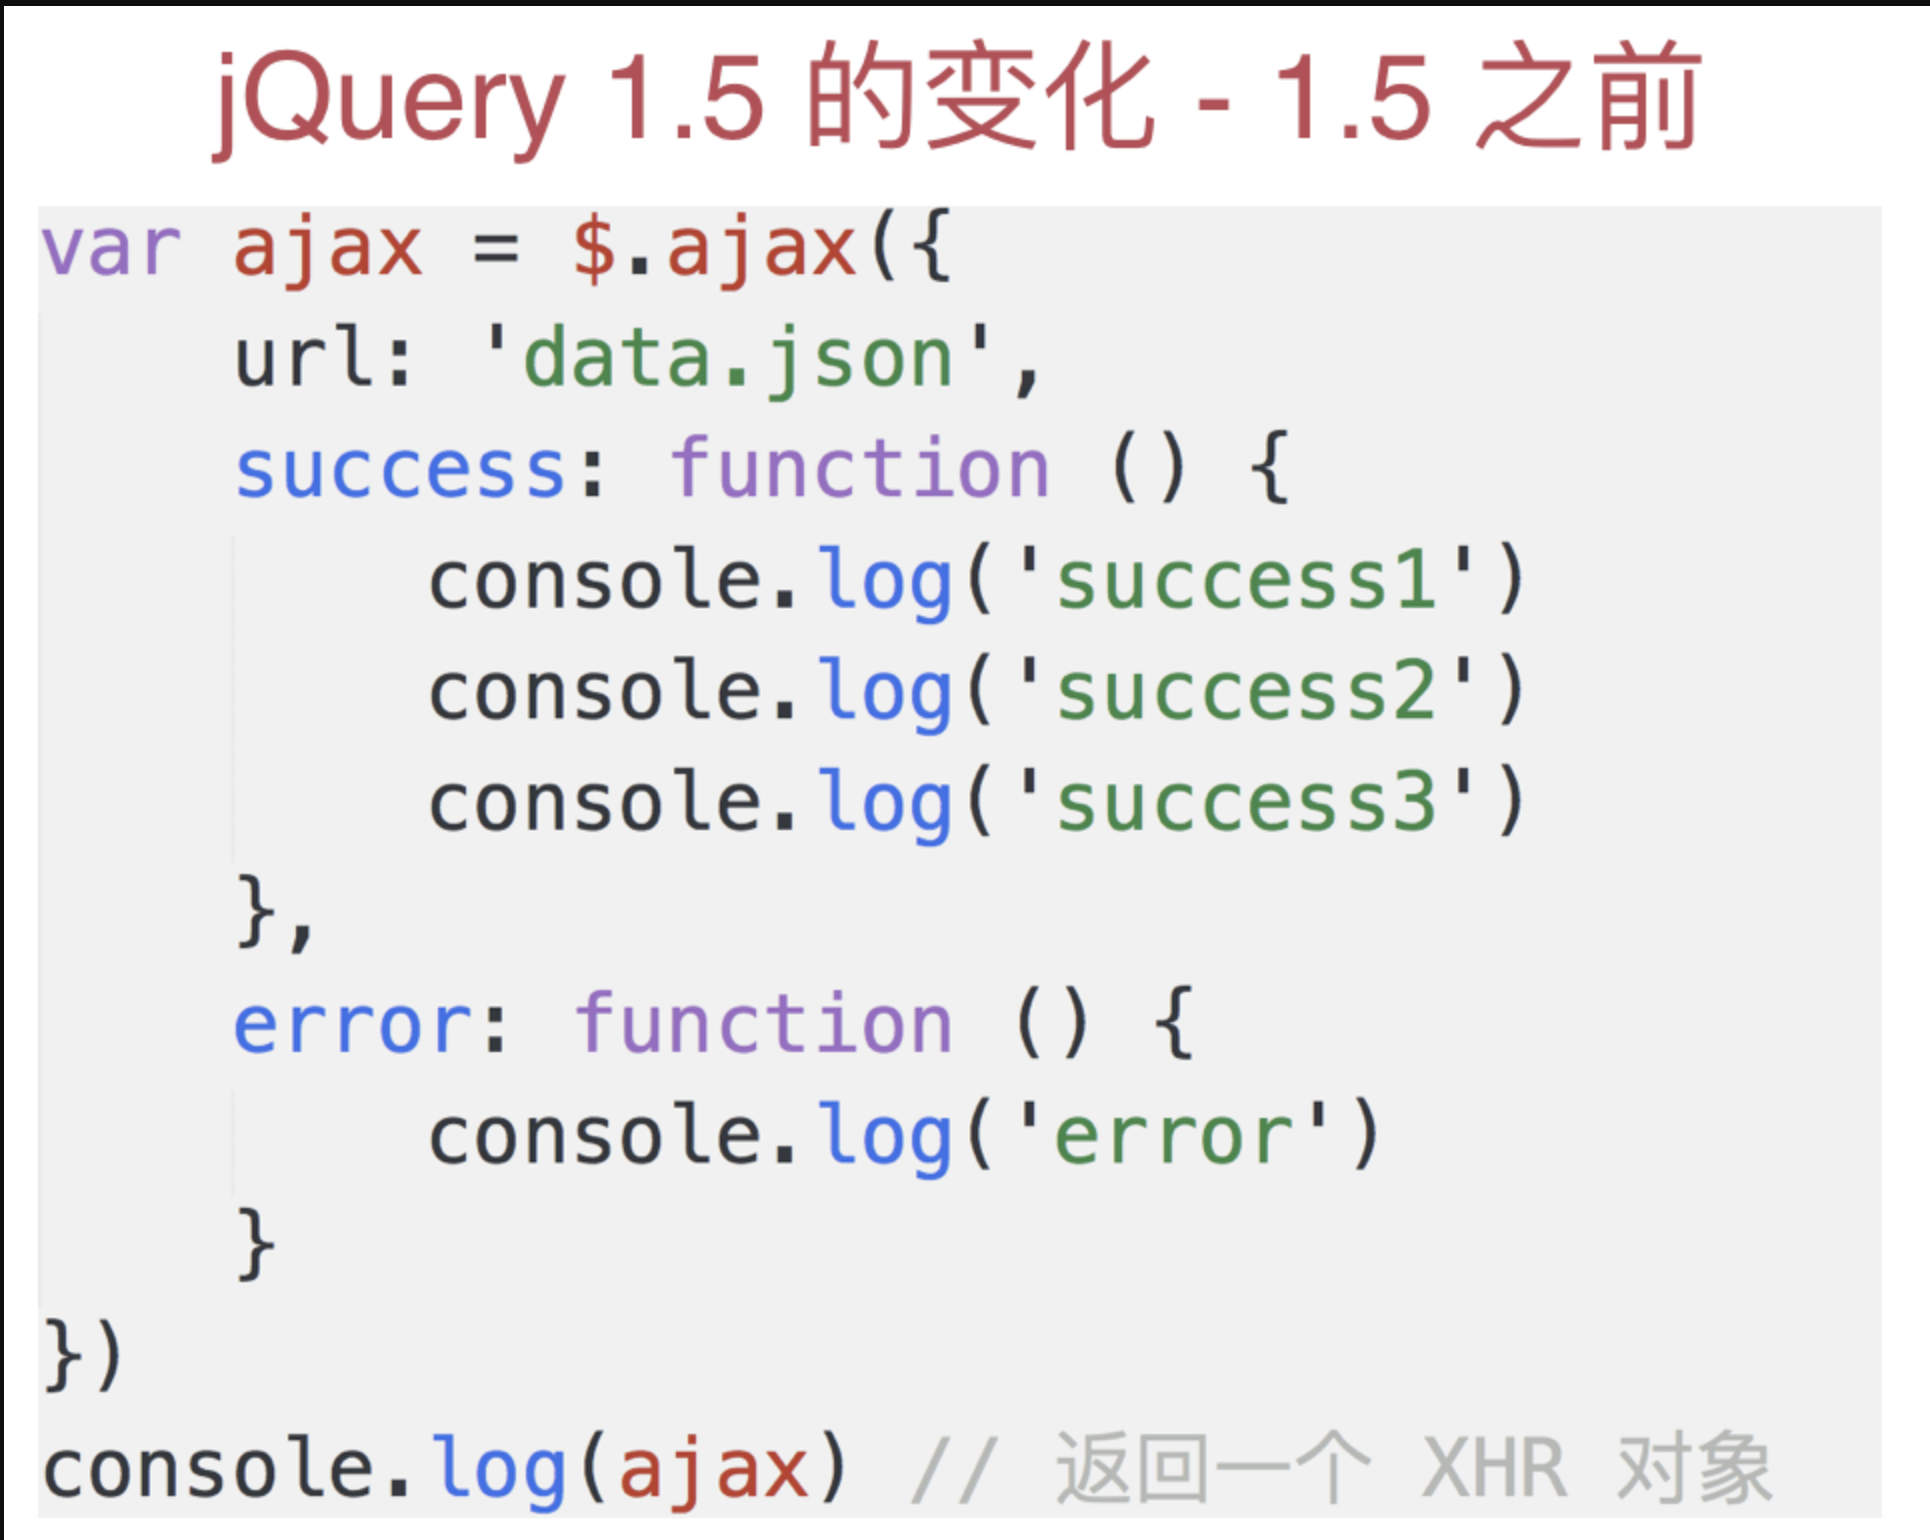


前端面试之hybrid
http://blog.poetries.top/2018/10/20/fe-interview-hybrid/(opens new window)
前端面试之组件化
http://blog.poetries.top/2018/10/20/fe-interview-component/(opens new window)
前端面试之MVVM浅析
http://blog.poetries.top/2018/10/20/fe-interview-mvvm/(opens new window)
实现效果,点击容器内的图标,图标边框变成border 1px solid red,点击空白处重置
1 | const box = document.getElementById('box'); |
JavaScript的组成
JavaScript由以下三部分组成:ECMAScript(核心):JavaScript` 语言基础DOM(文档对象模型):规定了访问HTML和XML的接口BOM(浏览器对象模型):提供了浏览器窗口之间进行交互的对象和方法
说几条写JavaScript的基本规范
- 代码缩进,建议使用“四个空格”缩进
- 代码段使用花括号
{}包裹 - 语句结束使用分号;
- 变量和函数在使用前进行声明
- 以大写字母开头命名构造函数,全大写命名常量
- 规范定义
JSON对象,补全双引号 - 用
{}和[]声明对象和数组
如何编写高性能的JavaScript
- 遵循严格模式:
"use strict"; - 将js脚本放在页面底部,加快渲染页面
- 将js脚本将脚本成组打包,减少请求
- 使用非阻塞方式下载js脚本
- 尽量使用局部变量来保存全局变量
- 尽量减少使用闭包
- 使用
window对象属性方法时,省略window - 尽量减少对象成员嵌套
- 缓存
DOM节点的访问 - 通过避免使用
eval()和Function()构造器 - 给
setTimeout()和setInterval()传递函数而不是字符串作为参数 - 尽量使用直接量创建对象和数组
- 最小化重绘(
repaint)和回流(reflow)
script 的位置是否会影响首屏显示时间
- 在解析
HTML生成DOM过程中,js文件的下载是并行的,不需要DOM处理到script节点。因此,script的位置不影响首屏显示的开始时间。 - 浏览器解析
HTML是自上而下的线性过程,script作为HTML的一部分同样遵循这个原则 - 因此,
script会延迟DomContentLoad,只显示其上部分首屏内容,从而影响首屏显示的完成时间
JS 实现一个类,实例化这个类
- 构造函数法(
this+prototype) – 用new关键字 生成实例对象- 缺点:用到了
this和prototype,编写复杂,可读性差
- 缺点:用到了
1 | function Mobile(name, price){ |
Object.create法 – 用Object.create()生成实例对象- 缺点:不能实现私有属性和私有方法,实例对象之间也不能共享数据
1 | var Person = { |
- 极简主义法(消除
this和prototype) – 调用createNew()得到实例对象- 优点:容易理解,结构清晰优雅,符合传统的”面向对象编程”的构造
1 | var Cat = { |
ES6语法糖class– 用new关键字 生成实例对象
1 | class Point { |
[“1”, “2”, “3”].map(parseInt)
[1, NaN, NaN]因为parseInt需要两个参数(val, radix),其中radix表示解析时用的基数。map传了3个(element, index, array),对应的radix不合法导致解析失败。
说说严格模式的限制
- 变量必须声明后再使用
- 函数的参数不能有同名属性,否则报错
- 不能使用with语句
- 不能对只读属性赋值,否则报错
- 不能使用前缀0表示八进制数,否则报错
- 不能删除不可删除的属性,否则报错
- 不能删除变量
delete prop,会报错,只能删除属性delete global[prop] eval不会在它的外层作用域引入变量eval和arguments不能被重新赋值arguments不会自动反映函数参数的变化- 不能使用
arguments.callee - 不能使用
arguments.caller - 禁止
this指向全局对象 - 不能使用
fn.caller和fn.arguments获取函数调用的堆栈 - 增加了保留字(比如
protected、static和interface)
“use strict”;是什么意思
use strict是一种ECMAscript 5添加的(严格)运行模式,这种模式使得 Javascript 在更严格的条件下运行,使JS编码更加规范化的模式,消除Javascript语法的一些不合理、不严谨之处,减少一些怪异行为
JSON 的了解
JSON(JavaScript Object Notation)是一种轻量级的数据交换格式- 它是基于
JavaScript的一个子集。数据格式简单, 易于读写, 占用带宽小 JSON字符串转换为JSON对象:
1 | var obj =eval('('+ str +')'); |
JSON对象转换为JSON字符串:
1 | var last=obj.toJSONString(); |
js延迟加载的方式有哪些
- 设置
<script>属性defer="defer"(脚本将在页面完成解析时执行) - 动态创建
script DOM:document.createElement('script'); XmlHttpRequest脚本注入- 延迟加载工具
LazyLoad
同步和异步的区别
- 同步:浏览器访问服务器请求,用户看得到页面刷新,重新发请求,等请求完,页面刷新,新内容出现,用户看到新内容,进行下一步操作
- 异步:浏览器访问服务器请求,用户正常操作,浏览器后端进行请求。等请求完,页面不刷新,新内容也会出现,用户看到新内容
渐进增强和优雅降级
- 渐进增强 :针对低版本浏览器进行构建页面,保证最基本的功能,然后再针对高级浏览器进行效果、交互等改进和追加功能达到更好的用户体验。
- 优雅降级 :一开始就构建完整的功能,然后再针对低版本浏览器进行兼容
attribute和property的区别是什么
attribute是dom元素在文档中作为html标签拥有的属性;property就是dom元素在js中作为对象拥有的属性。对于
html的标准属性来说,attribute和property是同步的,是会自动更新的但是对于自定义的属性来说,他们是不同步的
面向对象编程及面向过程编程,它们的异同和优缺点
- 面向过程就是分析出解决问题所需要的步骤,然后用函数把这些步骤一步一步实现,使用的时候一个一个依次调用就可以了
- 面向对象是把构成问题事务分解成各个对象,建立对象的目的不是为了完成一个步骤,而是为了描叙某个事物在整个解决问题的步骤中的行为
- 面向对象是以功能来划分问题,而不是步骤
面向对象编程思想
- 基本思想是使用对象,类,继承,封装等基本概念来进行程序设计
- 优点
- 易维护
- 采用面向对象思想设计的结构,可读性高,由于继承的存在,即使改变需求,那么维护也只是在局部模块,所以维护起来是非常方便和较低成本的
- 易扩展
- 开发工作的重用性、继承性高,降低重复工作量。
- 缩短了开发周期
- 易维护
对web标准、可用性、可访问性的理解
- 可用性(Usability):产品是否容易上手,用户能否完成任务,效率如何,以及这过程中用户的主观感受可好,是从用户的角度来看产品的质量。可用性好意味着产品质量高,是企业的核心竞争力
- 可访问性(Accessibility):Web内容对于残障用户的可阅读和可理解性
- 可维护性(Maintainability):一般包含两个层次,一是当系统出现问题时,快速定位并解决问题的成本,成本低则可维护性好。二是代码是否容易被人理解,是否容易修改和增强功能。
使用js实现一个持续的动画效果
定时器思路
1 | var e = document.getElementById('e') |
requestAnimationFrame
1 | //兼容性处理 |
使用css实现一个持续的动画效果
1 | animation:mymove 5s infinite; |
animation-name规定需要绑定到选择器的keyframe名称。animation-duration规定完成动画所花费的时间,以秒或毫秒计。animation-timing-function规定动画的速度曲线。animation-delay规定在动画开始之前的延迟。animation-iteration-count规定动画应该播放的次数。animation-direction规定是否应该轮流反向播放动画
封装一个函数,参数是定时器的时间,.then执行回调函数
1 | function sleep (time) { |
项目做过哪些性能优化?
- 减少
HTTP请求数 - 减少
DNS查询 - 使用
CDN - 避免重定向
- 图片懒加载
- 减少
DOM元素数量 - 减少
DOM操作 - 使用外部
JavaScript和CSS - 压缩
JavaScript、CSS、字体、图片等 - 优化
CSS Sprite - 使用
iconfont - 字体裁剪
- 多域名分发划分内容到不同域名
- 尽量减少
iframe使用 - 避免图片
src为空 - 把样式表放在
link中 - 把
JavaScript放在页面底部
尽可能多的说出你对 Electron 的理解
最最重要的一点,
electron实际上是一个套了Chrome的nodeJS程序
所以应该是从两个方面说开来
Chrome(无各种兼容性问题);NodeJS(NodeJS能做的它也能做)
XML和JSON的区别?
- 数据体积方面
JSON相对于XML来讲,数据的体积小,传递的速度更快些。
- 数据交互方面
JSON与JavaScript的交互更加方便,更容易解析处理,更好的数据交互
- 数据描述方面
JSON对数据的描述性比XML较差
- 传输速度方面
JSON的速度要远远快于XML
说说你对AMD和Commonjs的理解
CommonJS是服务器端模块的规范,Node.js采用了这个规范。CommonJS规范加载模块是同步的,也就是说,只有加载完成,才能执行后面的操作。AMD规范则是非同步加载模块,允许指定回调函数AMD推荐的风格通过返回一个对象做为模块对象,CommonJS的风格通过对module.exports或exports的属性赋值来达到暴露模块对象的目的
用过哪些设计模式?
- 工厂模式:
- 工厂模式解决了重复实例化的问题,但还有一个问题,那就是识别问题,因为根本无法
- 主要好处就是可以消除对象间的耦合,通过使用工程方法而不是
new关键字
- 构造函数模式
- 使用构造函数的方法,即解决了重复实例化的问题,又解决了对象识别的问题,该模式与工厂模式的不同之处在于
- 直接将属性和方法赋值给
this对象;
offsetWidth/offsetHeight,clientWidth/clientHeight与scrollWidth/scrollHeight的区别
offsetWidth/offsetHeight返回值包含content + padding + border,效果与e.getBoundingClientRect()相同clientWidth/clientHeight返回值只包含content + padding,如果有滚动条,也不包含滚动条scrollWidth/scrollHeight返回值包含content + padding + 溢出内容的尺寸
javascript有哪些方法定义对象
- 对象字面量:
var obj = {}; - 构造函数:
var obj = new Object(); - Object.create():
var obj = Object.create(Object.prototype);
常见兼容性问题?
png24位的图片在iE6浏览器上出现背景,解决方案是做成PNG8- 浏览器默认的
margin和padding不同。解决方案是加一个全局的*{margin:0;padding:0;}来统一,,但是全局效率很低,一般是如下这样解决:
1 | body,ul,li,ol,dl,dt,dd,form,input,h1,h2,h3,h4,h5,h6,p{ |
IE下,event对象有x,y属性,但是没有pageX,pageY属性Firefox下,event对象有pageX,pageY属性,但是没有x,y属性.
你觉得jQuery源码有哪些写的好的地方
jquery源码封装在一个匿名函数的自执行环境中,有助于防止变量的全局污染,然后通过传入window对象参数,可以使window对象作为局部变量使用,好处是当jquery中访问window对象的时候,就不用将作用域链退回到顶层作用域了,从而可以更快的访问window对象。同样,传入undefined参数,可以缩短查找undefined时的作用域链jquery将一些原型属性和方法封装在了jquery.prototype中,为了缩短名称,又赋值给了jquery.fn,这是很形象的写法- 有一些数组或对象的方法经常能使用到,
jQuery将其保存为局部变量以提高访问速度 jquery实现的链式调用可以节约代码,所返回的都是同一个对象,可以提高代码效率
Node的应用场景
- 特点:
- 1、它是一个
Javascript运行环境 - 2、依赖于
Chrome V8引擎进行代码解释 - 3、事件驱动
- 4、非阻塞
I/O - 5、单进程,单线程
- 1、它是一个
- 优点:
- 高并发(最重要的优点)
- 缺点:
- 1、只支持单核
CPU,不能充分利用CPU - 2、可靠性低,一旦代码某个环节崩溃,整个系统都崩溃
- 1、只支持单核
谈谈你对AMD、CMD的理解
CommonJS是服务器端模块的规范,Node.js采用了这个规范。CommonJS规范加载模块是同步的,也就是说,只有加载完成,才能执行后面的操作。AMD规范则是非同步加载模块,允许指定回调函数AMD推荐的风格通过返回一个对象做为模块对象,CommonJS的风格通过对module.exports或exports的属性赋值来达到暴露模块对象的目的
es6模块 CommonJS、AMD、CMD
CommonJS的规范中,每个JavaScript文件就是一个独立的模块上下文(module context),在这个上下文中默认创建的属性都是私有的。也就是说,在一个文件定义的变量(还包括函数和类),都是私有的,对其他文件是不可见的。CommonJS是同步加载模块,在浏览器中会出现堵塞情况,所以不适用AMD异步,需要定义回调define方式es6一个模块就是一个独立的文件,该文件内部的所有变量,外部无法获取。如果你希望外部能够读取模块内部的某个变量,就必须使用export关键字输出该变量es6还可以导出类、方法,自动适用严格模式
web开发中会话跟踪的方法有哪些
cookiesessionurl重写- 隐藏
input ip地址
说几条写JavaScript的基本规范
- 不要在同一行声明多个变量
- 请使用
===/!==来比较true/false或者数值 - 使用对象字面量替代
new Array这种形式 - 不要使用全局函数
Switch语句必须带有default分支If语句必须使用大括号for-in循环中的变量 应该使用var关键字明确限定作用域,从而避免作用域污
JS 创建对象的几种方式
javascript创建对象简单的说,无非就是使用内置对象或各种自定义对象,当然还可以用JSON;但写法有很多种,也能混合使用
- 对象字面量的方式
1 | person={firstname:"Mark",lastname:"Yun",age:25,eyecolor:"black"}; |
- 用
function来模拟无参的构造函数
1 | function Person(){} |
- 用
function来模拟参构造函数来实现(用this关键字定义构造的上下文属性)
1 | function Pet(name,age,hobby){ |
- 用工厂方式来创建(内置对象)
1 | var wcDog =new Object(); |
- 用原型方式来创建
1 | function Dog(){} |
- 用混合方式来创建
1 | function Car(name,price){ |
eval是做什么的
- 它的功能是把对应的字符串解析成
JS代码并运行 - 应该避免使用
eval,不安全,非常耗性能(2次,一次解析成js语句,一次执行) - 由
JSON字符串转换为JSON对象的时候可以用eval,var obj =eval('('+ str +')')
未解决的题目
JS 数字前补“0”
1 | //迭代方式实现 |
(num + "").length可以确定当前数值的长度,根据此来填充return (Array(length).join("0") + num).slice(-length);转为小数 较为复杂